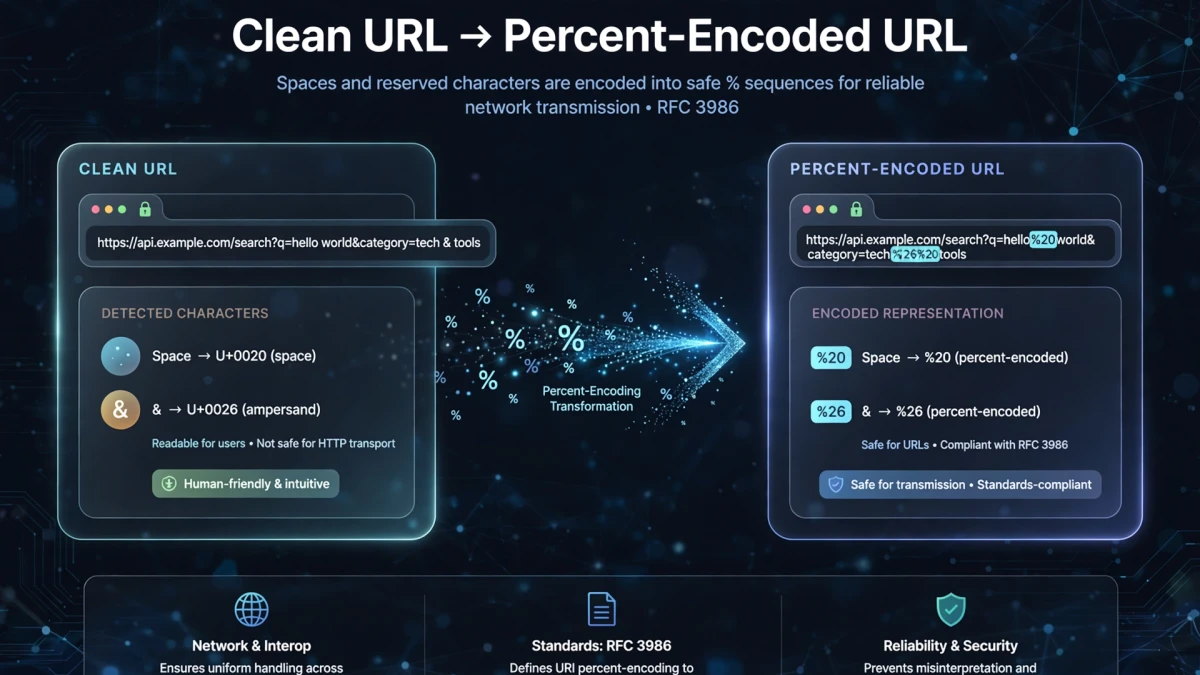
为什么网址需要特殊字符编码
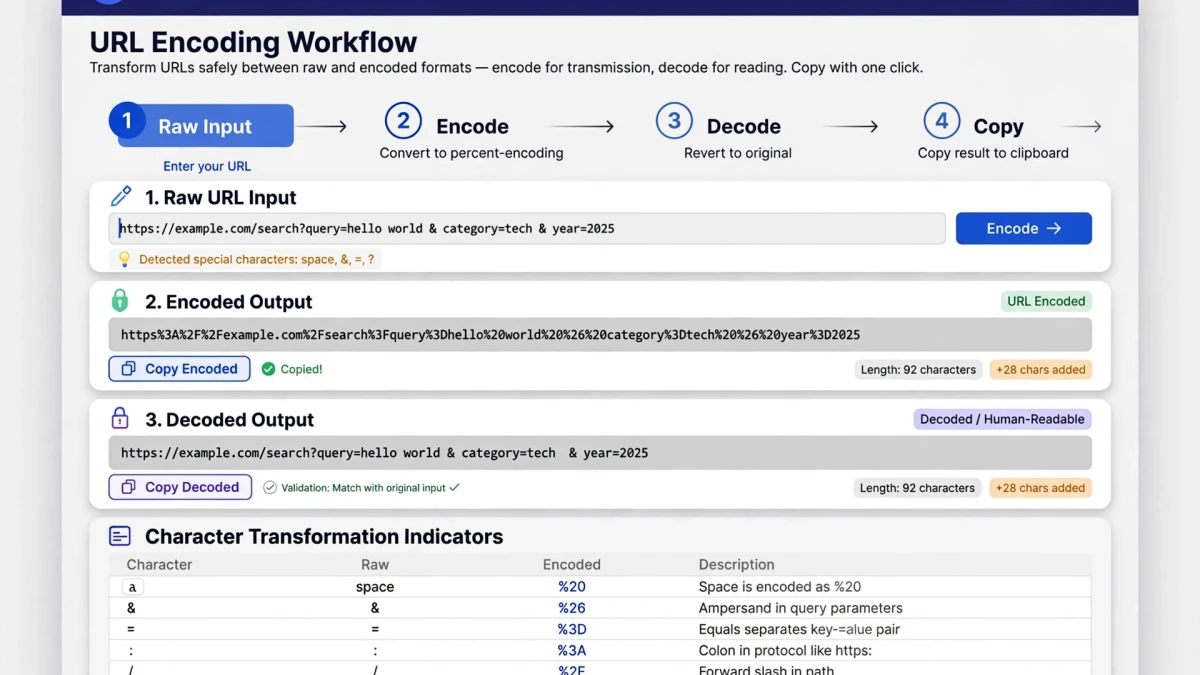
URL 使用 HTTP 协议通过网络传输。 HTTP 规范(及其前身,互联网协议标准)将 URL 限制为 US-ASCII 字符的子集,特别是字节值在 0x21 到 0x7E 之间的字符。
此范围之外的字符(包括空格、重音字符 (é、ñ、ü)、中文/日文/韩文字符和许多符号)在未经编码的 URL 中并不安全。
为什么要特别使用空格? HTTP 在请求行中使用空格作为方法、URL 和协议版本之间的分隔符:
GET /search?q=hello world HTTP/1.1服务器将“hello”视为 URL 结尾,将“world”视为 HTTP 版本字符串的无效部分。该网址已损坏。
解决方案:百分比编码(在 RFC 3986 中定义)将不安全字符转换为安全的 %XX 表示法,其中 XX 是十六进制字节值。
百分比编码的工作原理
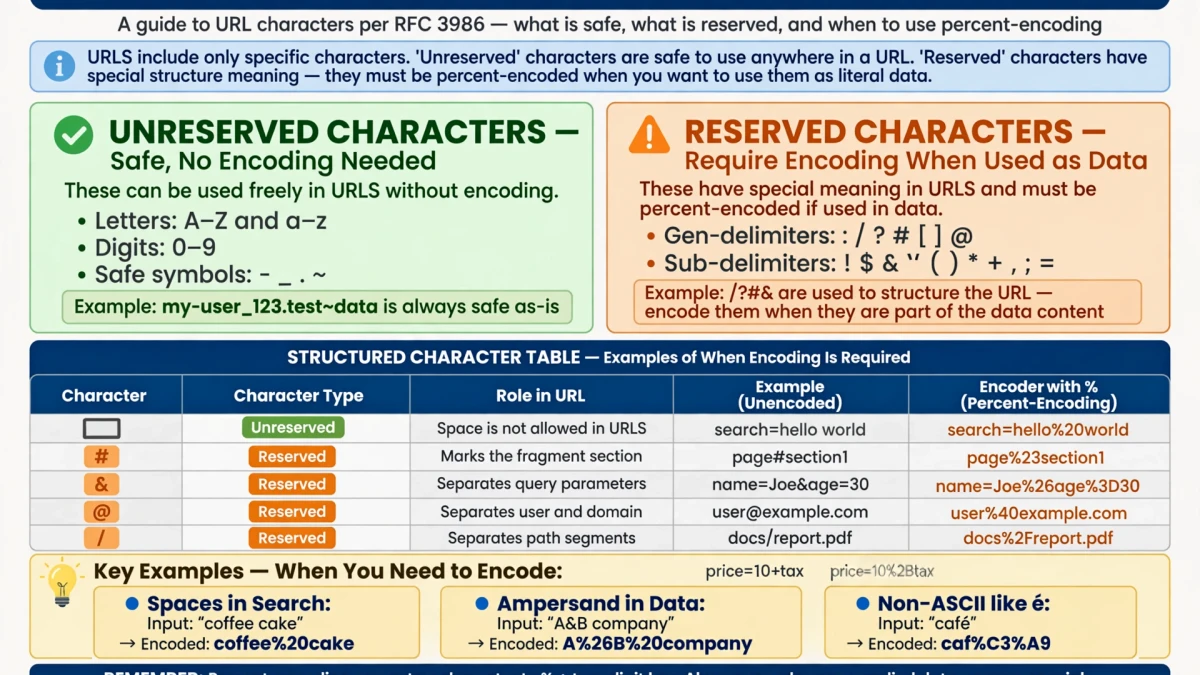
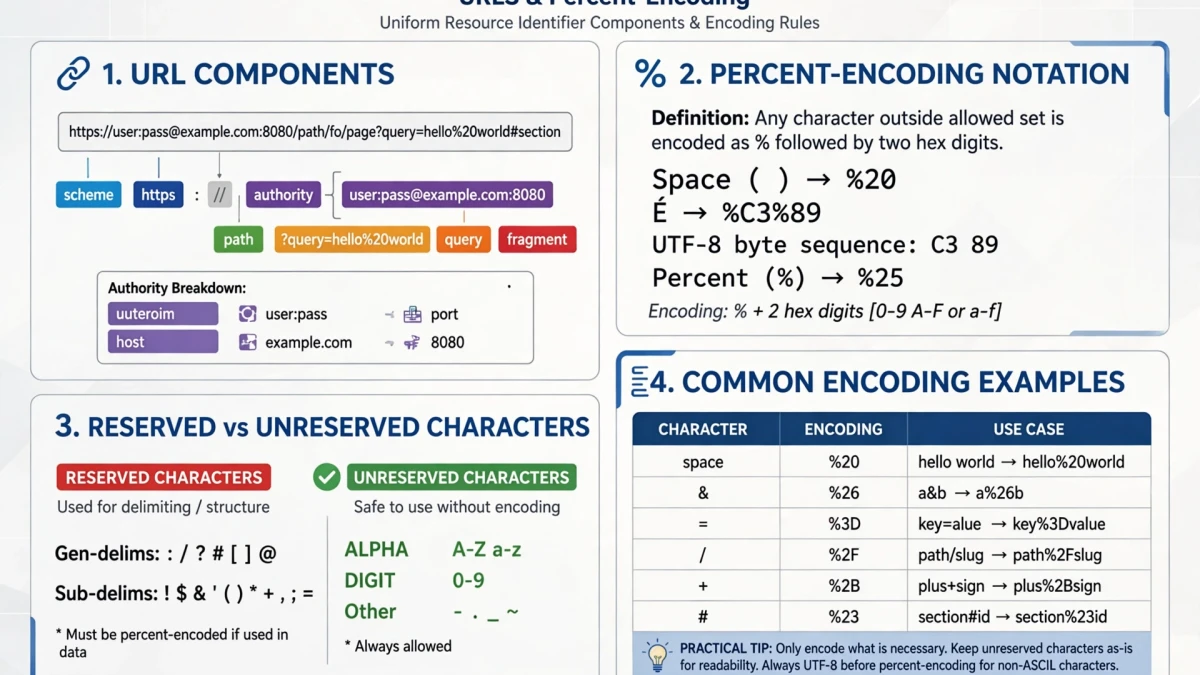
UTF-8 中的每个字符都是一到四个字节。百分比编码将每个字节转换为 % 后跟两个十六进制数字:
| 字符 | UTF-8字节 | 百分比编码 |
|---|---|---|
| 空间 | 0x20 | %20 |
| # | 0x23 | %23 |
| & | 0x26 | %26 |
| = | 0x3D | %3D |
| / | 0x2F | ]%2F |
| é | 0xC3 0xA9 | %C3%A9 |
| 中 | 0xE4 0xB8 0xAD | %E4%B8%AD |
包含 https://example.com/search 等汉字的网址将变为:https://example.com/%E6%90%9C%E7%B4%A2
保留字符与非保留字符
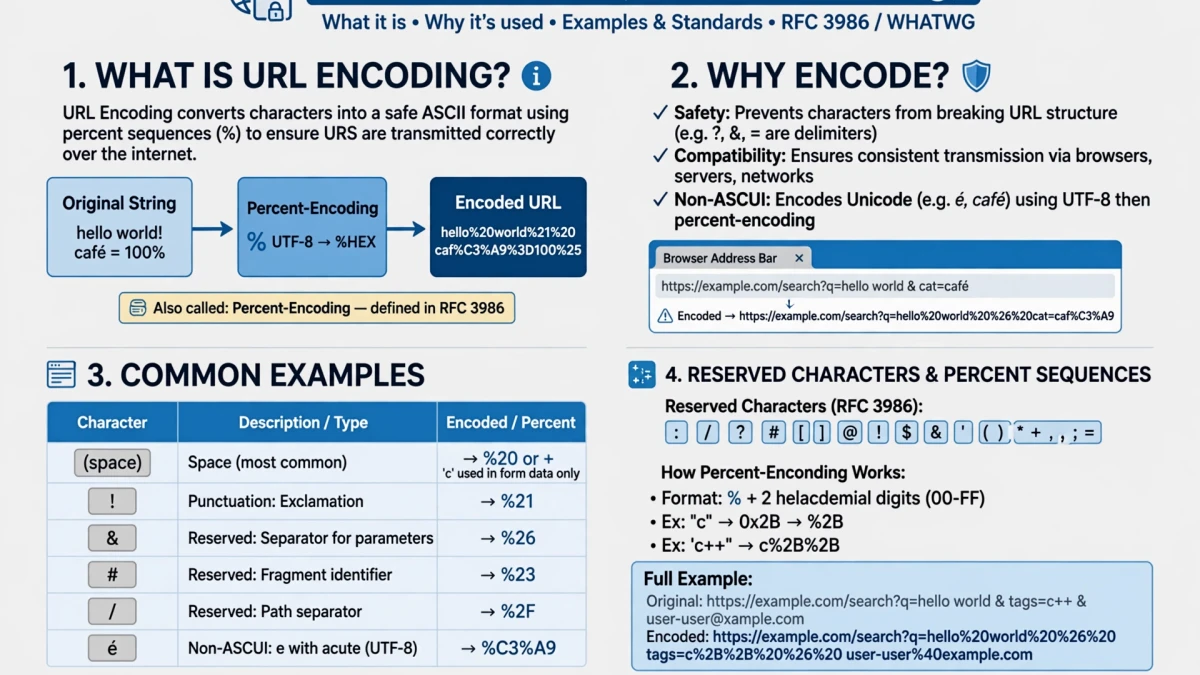
非保留字符(切勿对这些字符进行编码): A-Z a-z 0-9 - _ 。 ~ 这些在所有 URL 上下文中都是安全的,并且应始终显示为未编码。
保留字符(用作数据时进行编码,而不是用作分隔符): :/ ? #[]@! $ & ' ( ) * + , ; = 这些字符在网址中具有特殊含义。当它们作为文字数据出现在查询参数值中时对其进行编码。
示例 - 搜索查询网址:
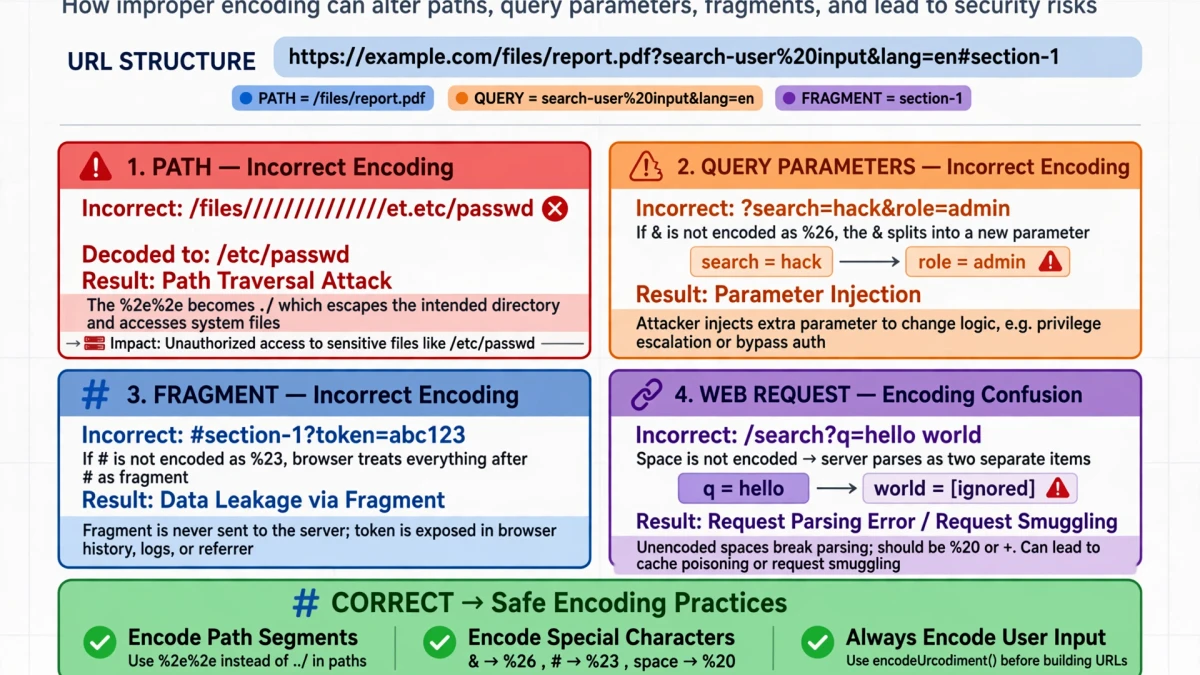
https://example.com/search?q=cats&dogs这是不明确的 - 查询是“cats”还是“cats&dogs”?使用编码:
https://example.com/search?q=cats%26dogs现在,& 符号被编码为数据,而不是查询参数分隔符。
ToolDolfen 上的网址编码和解码
- 打开 URL网址编解码工具。
- 要进行编码: 粘贴包含特殊字符的 URL 或 URL 组件。点击“编码”。
- 解码:粘贴百分比编码的网址或字符串以查看人类可读的原始内容。
该工具可处理完整 URL 和 URL 组成部分(单个查询参数值)。对于完整的URL编码,仅对非保留字符进行编码;对于组件编码,保留字符也会被编码。