Cómo extraer texto sin formato de documentos PDF: PDF seleccionables versus escaneados

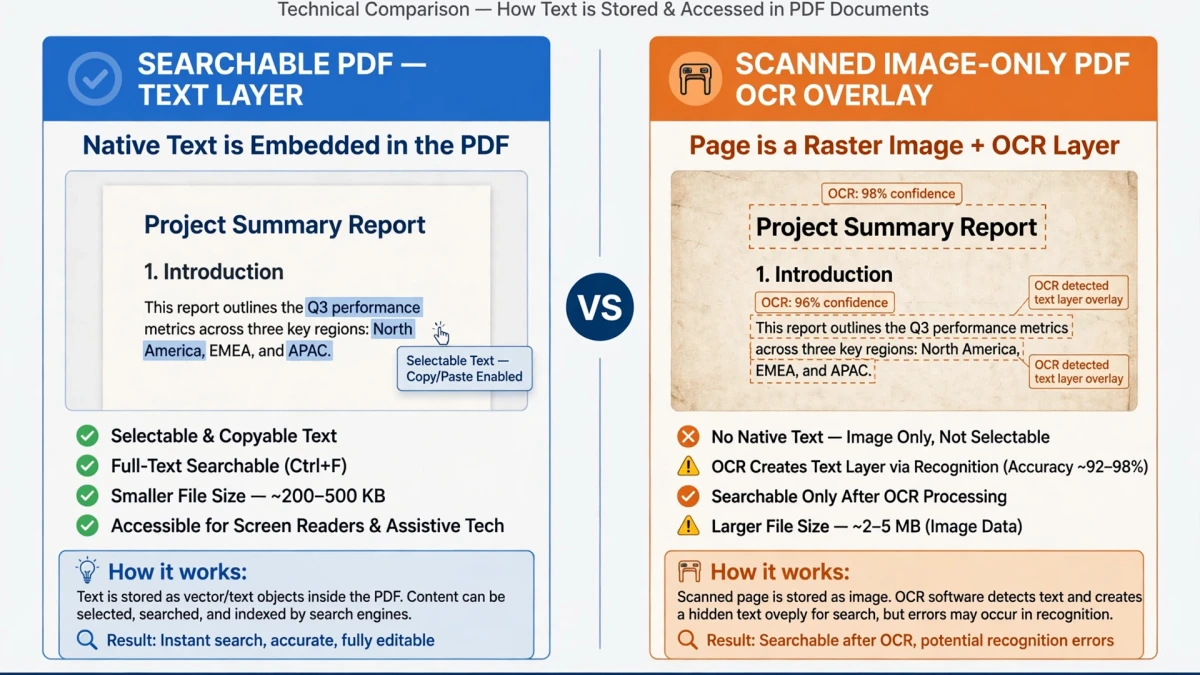
La extracción de texto PDF funciona instantáneamente para archivos PDF con texto seleccionable (creados en Word, InDesign, etc.). Los archivos PDF escaneados son imágenes: requieren tecnología OCR para reconocer y convertir caracteres.

PDF document with selectable text being extracted to plaintext document cleanly

PDF de texto seleccionables frente a PDF de imágenes escaneadas
Font encoding and ToUnicode CMap tables mapping internal glyph IDs to UTF-8 characters

PDF internal text stream syntax showing BT, Tf, Td, Tj, and ET operators

Comprender qué tipo de PDF tienes determina cómo extraes el texto:

PDF de texto seleccionables:

  • Creado directamente desde aplicaciones: Microsoft Word, Google Docs, Adobe InDesign, PowerPoint
  • Los caracteres se almacenan como objetos de texto Unicode en la estructura del archivo PDF
  • Puedes seleccionar y copiar texto directamente en cualquier PDF visor
  • Las herramientas de extracción de texto funcionan instantáneamente sin ningún procesamiento de imágenes
  • Ejemplo: un contrato creado en Word y exportado como PDF

PDF de imágenes escaneadas:

  • Creado escaneando documentos físicos en papel
  • El PDF contiene imágenes de la página: fotografías del documento
  • Sin objetos de texto: el texto existe solo como píxeles en la imagen
  • Tú no puedo seleccionar ni copiar texto en un visor de PDF estándar
  • Requiere OCR para reconocer y convertir caracteres de píxeles en texto editable
  • Ejemplo: un contrato en papel firmado, fotografiado o escaneado

Cómo identificar qué tipo tienes: Intenta seleccionar texto en tu visor de PDF. Si puede resaltar palabras individuales, es un PDF seleccionable. Si al arrastrar se selecciona toda la página como imagen, es un PDF escaneado.


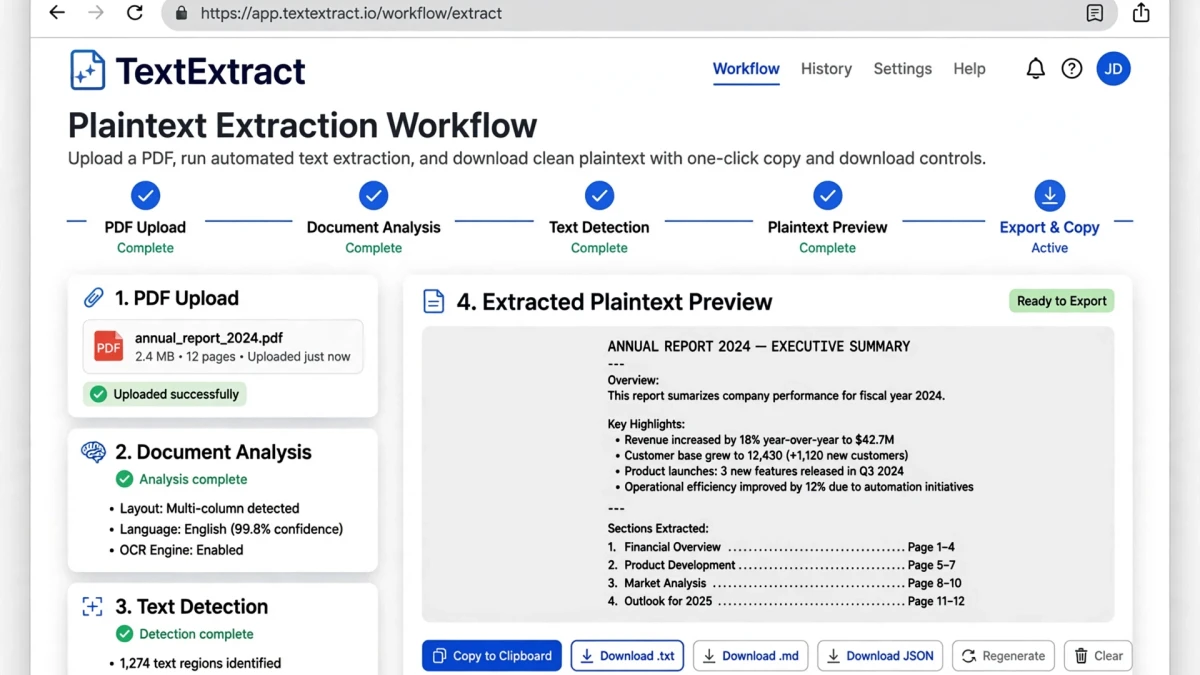
Paso a paso: extraer texto de PDF en ToolDolfen

Formatted PDF document page versus clean machine-readable plaintext extraction comparison

ToolDolfen in-browser PDF plaintext extractor client-side workflow pipeline

Preserving natural paragraph reflow and word spacing from disjointed PDF coordinates

  1. Abre la herramienta Extractor de Texto de PDF (PDF Text Extractor).
  2. Sube tu PDF.
  3. La herramienta detecta automáticamente si el PDF se puede seleccionar texto:

- PDF seleccionable: El texto se extrae inmediatamente con alta precisión - PDF escaneado: OCR se aplica automáticamente para reconocer caracteres

  1. Copie el texto extraído o descárguelo como un archivo .txt.

Nota de formato: El texto extraído es solo texto sin formato. Las tablas se convierten en filas separadas por tabulaciones. Los encabezados y el espaciado entre párrafos son aproximados. Para conservar el diseño, utilice una herramienta de conversión de Word.

Guías complementarias recomendadas

Explore tutoriales y utilidades complementarios de este grupo de temas para mejorar su flujo de trabajo digital:

Cómo convertir PDF a Word editable (DOCX): precisión y preservación del formatoTutorial práctico paso a paso con estándares verificados y en el navegador flujos de trabajo.Seguridad de metadatos PDF: cómo desinfectar documentos antes de compartirlosTutorial práctico paso a paso con estándares verificados y en el navegador flujos de trabajo.Cómo extraer imágenes de alta resolución de documentos PDF en líneaTutorial práctico paso a paso con estándares verificados y en el navegador flujos de trabajo.Conversión de CSV a JSON: análisis de tipos, objetos anidados y manejo de encabezadosFlujo de trabajo complementario de formato cruzado que conecta datos y medios relacionados herramientas.
Utilidad recomendada: PDF Text ExtractorEjecute este flujo de trabajo en vivo en su navegador sin cargas en el servidor y 100% de privacidad del lado del cliente.
Extractor de Texto de PDF (PDF Text Extractor)

Preguntas Frecuentes

Encuentra respuestas rápidas y verificadas a las preguntas comunes sobre este flujo de trabajo.

¿Por qué no puedo copiar y pegar texto de mi PDF?

Si no se puede seleccionar texto en su PDF, es probable que el documento sea un PDF escaneado (una colección de imágenes de páginas sin texto incrustado). Necesita OCR para extraer texto de archivos PDF escaneados. Para archivos PDF basados ​​en texto, copiar y pegar debería funcionar directamente.

¿La extracción de texto PDF conserva el formato?

La extracción de texto sin formato elimina el formato (fuentes, colores, tablas). El resultado es texto sin formato. Para preservar el formato del documento, considere convertirlo a un formato compatible con Word en lugar de extraer texto sin formato.

Bilal Ahmad