
Cara Kerja Teknologi OCR

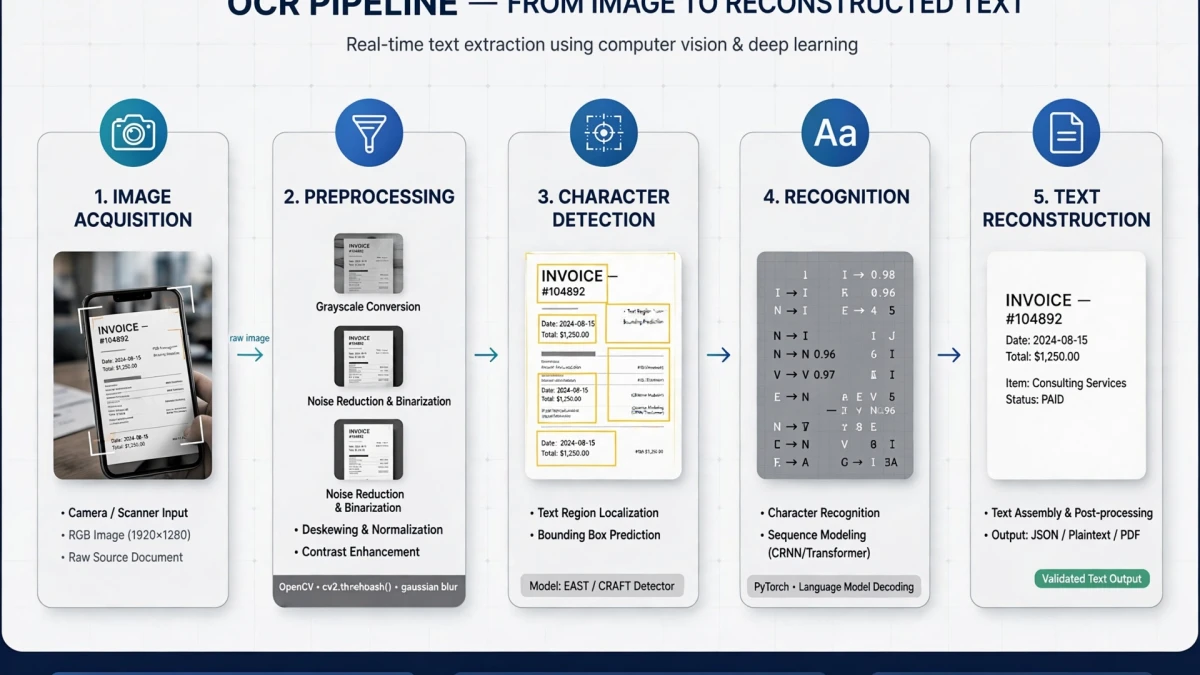
Pengenalan Karakter Optik menggunakan visi komputer untuk mengidentifikasi karakter teks dalam gambar. Saluran OCR modern:
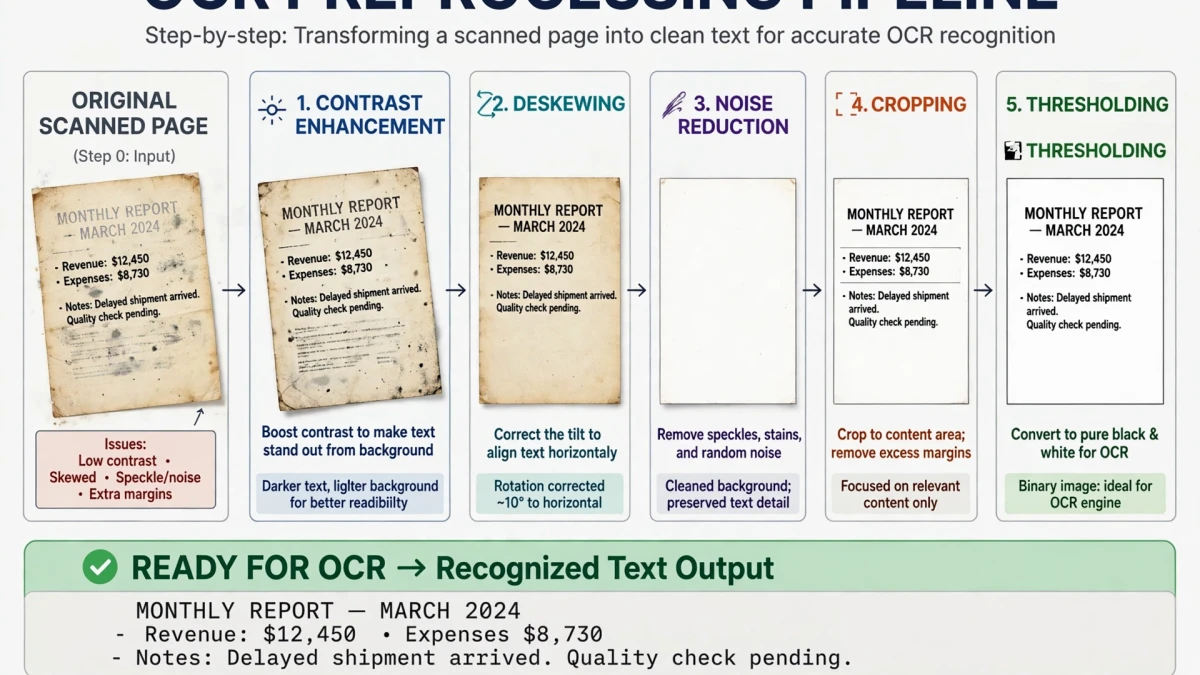
1. Pemrosesan awal gambar Sebelum pengenalan karakter, gambar dibersihkan:
- Konversi skala abu-abu (menghilangkan noise warna)
- Binarisasi (mengonversi menjadi hitam putih)
- Deskewing (meluruskan dokumen yang miring)
- Pengurangan noise (menghilangkan artefak dan bintik pemindai)
- Deteksi garis (mengidentifikasi baris teks)
2. Segmentasi karakter Gambar yang telah diproses sebelumnya dibagi menjadi wilayah karakter individual. Untuk skrip Latin, hal ini melibatkan identifikasi batas kata, lalu kotak karakter individual.
3. Ekstraksi fitur Setiap fitur karakter diekstraksi: lebar guratan, kurva, perpotongan, rasio aspek, pola kepadatan piksel.
4. Pencocokan pola Fitur yang diekstraksi dibandingkan dengan model karakter terlatih. OCR tradisional menggunakan pencocokan template; OCR modern menggunakan pembelajaran mendalam (jaringan saraf konvolusional) yang mengenali karakter sebagai pola holistik, menangani variasi dan degradasi font dengan baik.
5. Pasca-pemrosesan kontekstual Model bahasa memeriksa karakter yang dikenali berdasarkan kamus dan aturan tata bahasa, mengoreksi "1earn" menjadi "learn" dan "rn" salah membaca sebagai "m" dalam konteks.
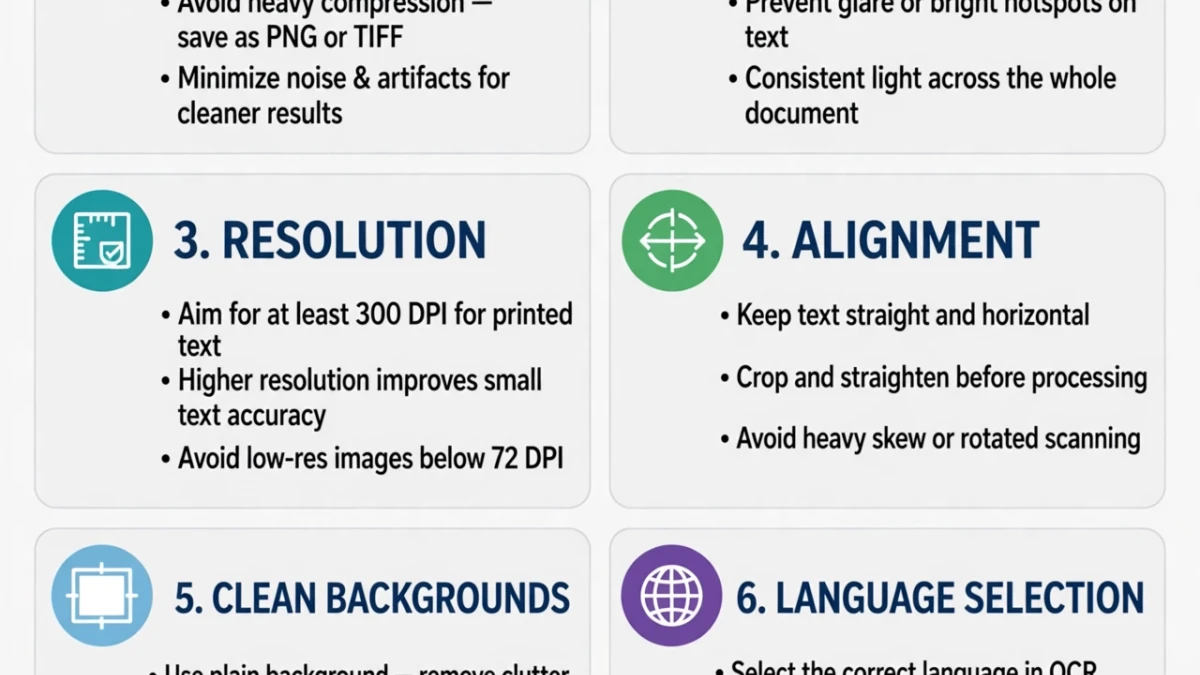
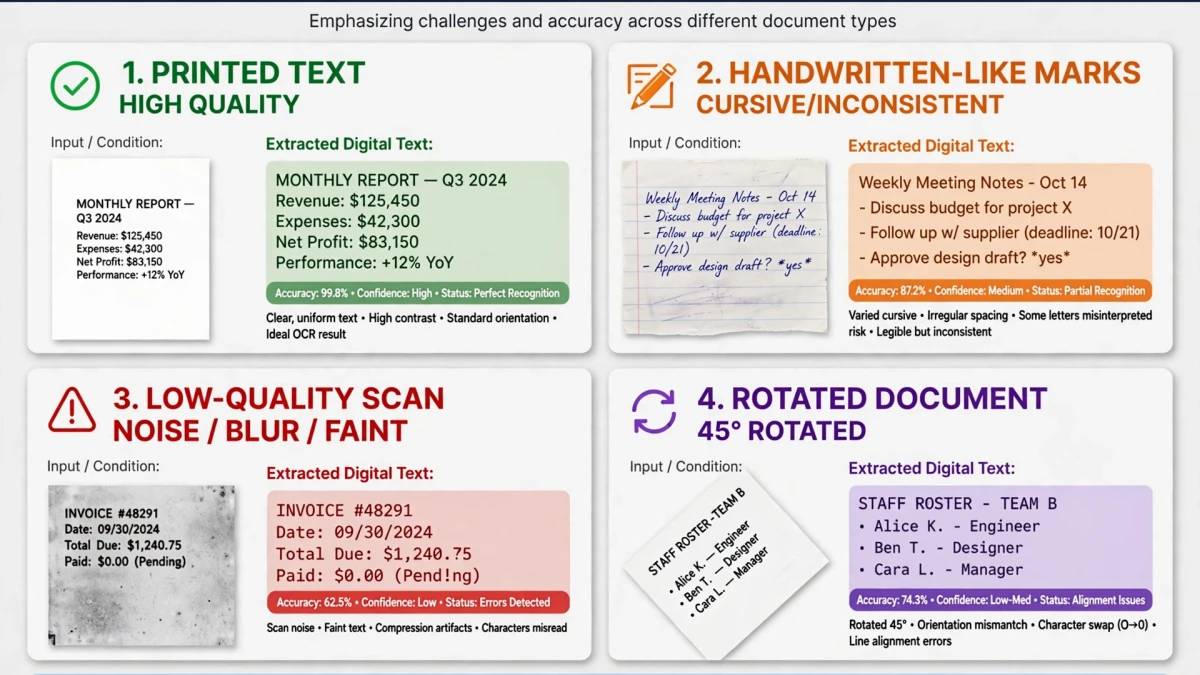
Yang Mempengaruhi Akurasi OCR
| Faktor | Dampak pada Akurasi |
|---|---|
| Resolusi pemindaian (DPI) | Sangat tinggi — diperlukan 300+ DPI agar dapat diandalkan hasil |
| Ketajaman gambar | Sangat tinggi — penyebab teks buram kesalahan |
| Ukuran font | Tinggi — font di bawah 8pt menantang |
| Font ketik | Sedang — serif dan sans-serif berfungsi dengan baik; font dekoratif sulit dilakukan |
| Kebersihan dokumen | Tinggi — penyebab noda kopi, lipatan, bekas pensil kesalahan |
| Pilihan bahasa | Tinggi — memilih model bahasa yang salah akan mengurangi akurasi |
| Kontras warna teks | Sedang — hitam di atas putih sudah optimal |
Menggunakan OCR di ToolDolfen
- Buka alat Gambar ke Teks (OCR) alat.
- Unggah dokumen pindaian atau foto teks Anda.
- Pilih bahasa teks (Bahasa Inggris adalah default; tersedia bahasa tambahan).
- Klik Ekstrak Teks.
- Tinjau hasilnya dan perbaiki kesalahan pengenalan apa pun.
- Salin teks yang diekstraksi ke Anda papan klip.
Praktik terbaik untuk akurasi tinggi:
- Pindai dengan kecepatan minimum 300 DPI
- Pastikan pencahayaan yang baik jika memotret dokumen (hindari bayangan dan silau)
- Ratakan buku dan dokumen untuk menghilangkan kelengkungan halaman
- Pilih bahasa yang benar untuk dokumen
Panduan Pendamping yang Direkomendasikan
Jelajahi tutorial dan utilitas pelengkap dari cluster topik ini untuk menyempurnakan alur kerja digital Anda: