
OCR Teknolojisi Nasıl Çalışır?

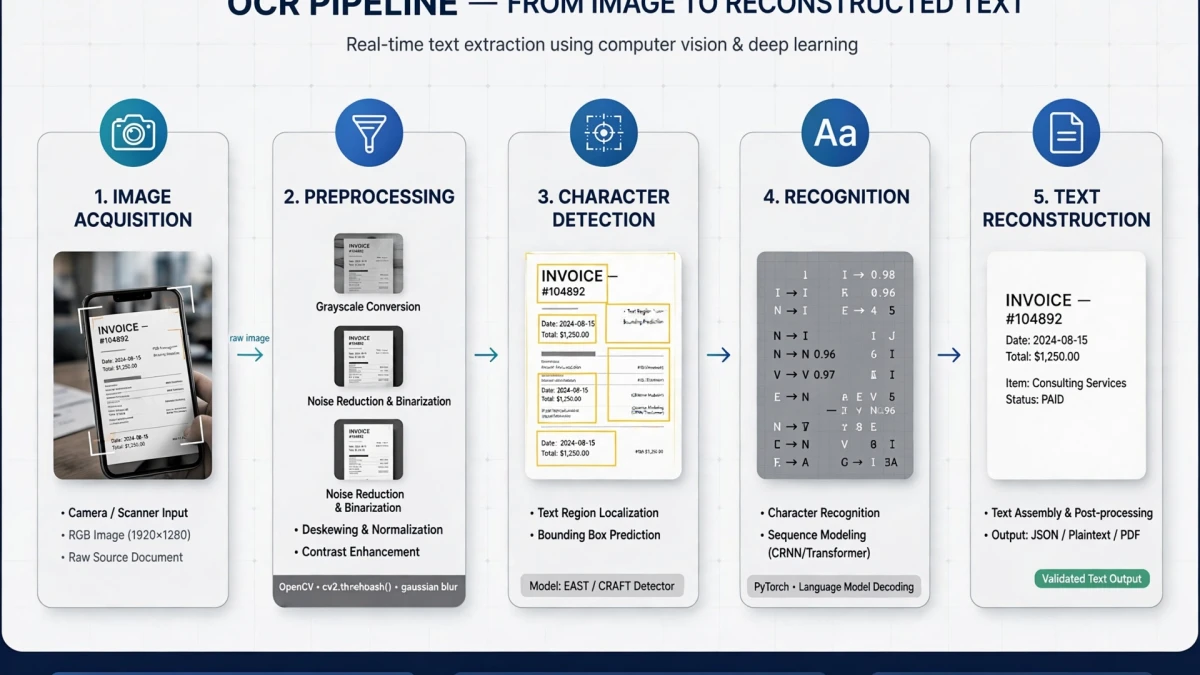
Optik Karakter Tanıma, görüntülerdeki metin karakterlerini tanımlamak için bilgisayar görüşünü kullanır. Modern OCR hattı:
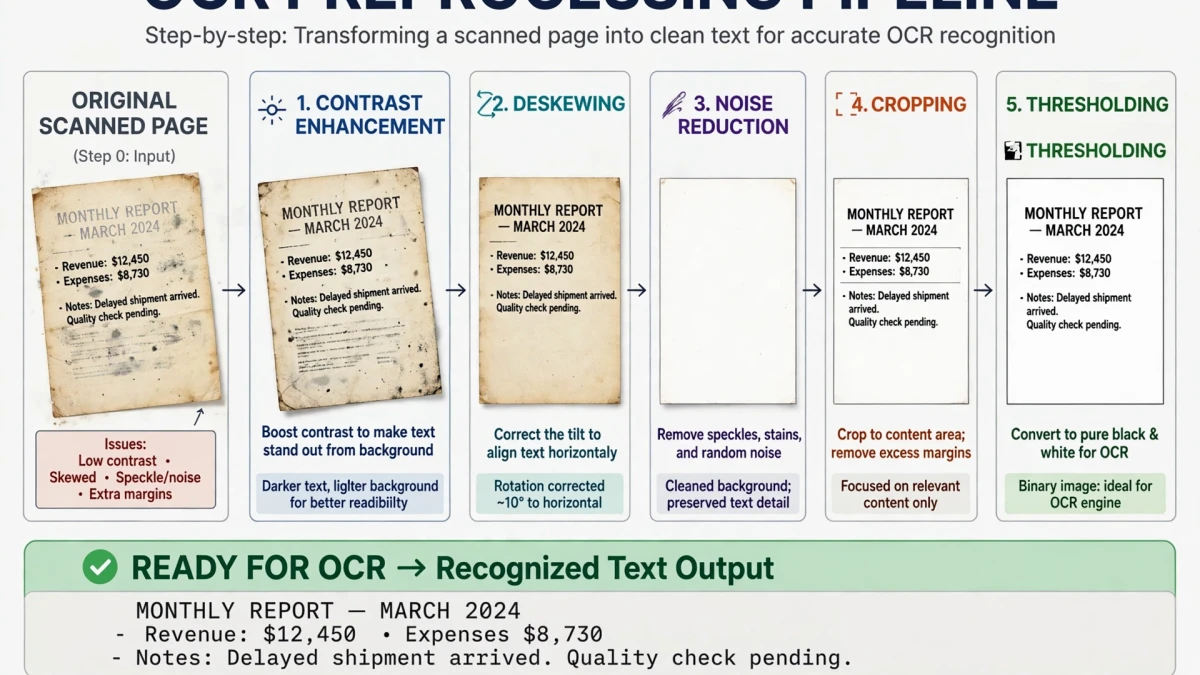
1. Görüntü ön işleme Karakter tanımadan önce görüntü temizlenir:
- Gri tonlama dönüştürme (renk parazitini ortadan kaldırır)
- İkilileştirme (siyah beyaza dönüştürür)
- Eğrilik giderme (eğimli belgeleri düzeltir)
- Gürültü azaltma (tarayıcı bozukluklarını ve beneklerini kaldırır)
- Çizgi algılama (metin satırlarını tanımlar)
2. Karakter segmentasyonu Önceden işlenmiş görüntü ayrı karakter bölgelerine bölünür. Latin alfabeleri için bu, kelime sınırlarının tanımlanmasını ve ardından ayrı ayrı karakter kutularının tanımlanmasını içerir.
3. Özellik çıkarma Her karakterin özellikleri çıkarılır: çizgi genişliği, eğriler, kesişimler, en boy oranı, piksel yoğunluğu desenleri.
4. Desen eşleştirme Çıkarılan özellikler, eğitilmiş karakter modelleriyle karşılaştırılır. Geleneksel OCR kullanılan şablon eşleştirme; modern OCR, karakterleri bütünsel modeller olarak tanıyan, yazı tipi değişikliklerini ve bozulmayı güçlü bir şekilde ele alan derin öğrenmeyi (evrişimli sinir ağları) kullanır.
5. Bağlamsal sonradan işleme Bir dil modeli, tanınan karakterleri bir sözlük ve dilbilgisi kurallarına göre kontrol ederek "1earn" ifadesini "learn" olarak düzeltir ve "rn" ifadesini bağlamda "m" olarak yanlış okur.
OCR Doğruluğunu Neler Etkiler?
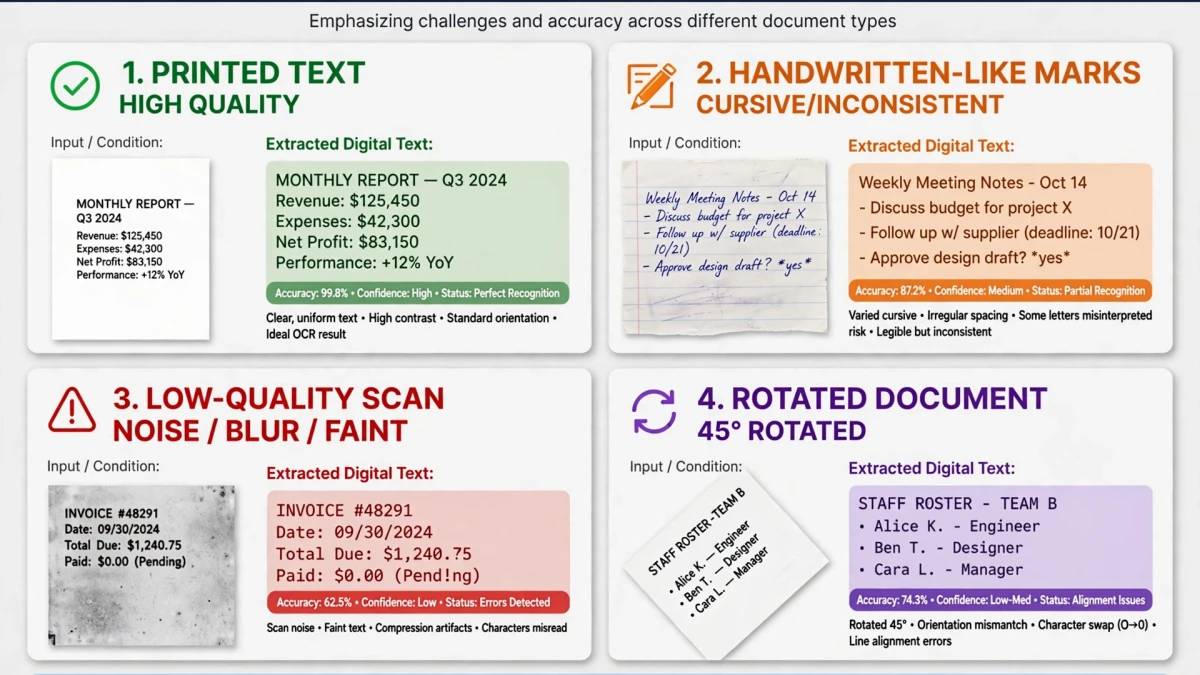
| Faktör | Etkisi Doğruluk |
|---|---|
| Tarama çözünürlüğü (DPI) | ]Çok yüksek — Güvenilirlik için 300'den fazla DPI gerekir sonuçlar |
| Görüntü keskinliği | Çok yüksek — bulanık metinlere neden olur hatalar |
| Yazı tipi boyutu | Yüksek — 8 puntodan küçük yazı tipleri zorlu |
| Yazı tipi türü | Orta — serif ve sans-serif iyi çalışır; dekoratif yazı tipleri zordur |
| Belge temizliği | Yüksek — kahve lekeleri, kıvrımlar, kalem izleri neden olur hatalar |
| Dil seçimi | Yüksek — yanlış dil modelinin seçilmesi, doğruluk |
| Metin rengi kontrastı | Orta — beyaz üzerine siyah en uygunudur |
ToolDolfen'de OCR kullanma
- Resimden Metne Dönüştürücü (OCR) aracını açın.
- Taranan belgenizi veya metin fotoğrafını yükleyin.
- Metin dilini seçin (İngilizce varsayılan; ek diller mevcut).
- Metni Çıkart'ı tıklayın.
- Çıktıyı inceleyin ve tanıma hatalarını düzeltin.
- Çıkartılan metni bilgisayarınıza kopyalayın pano.
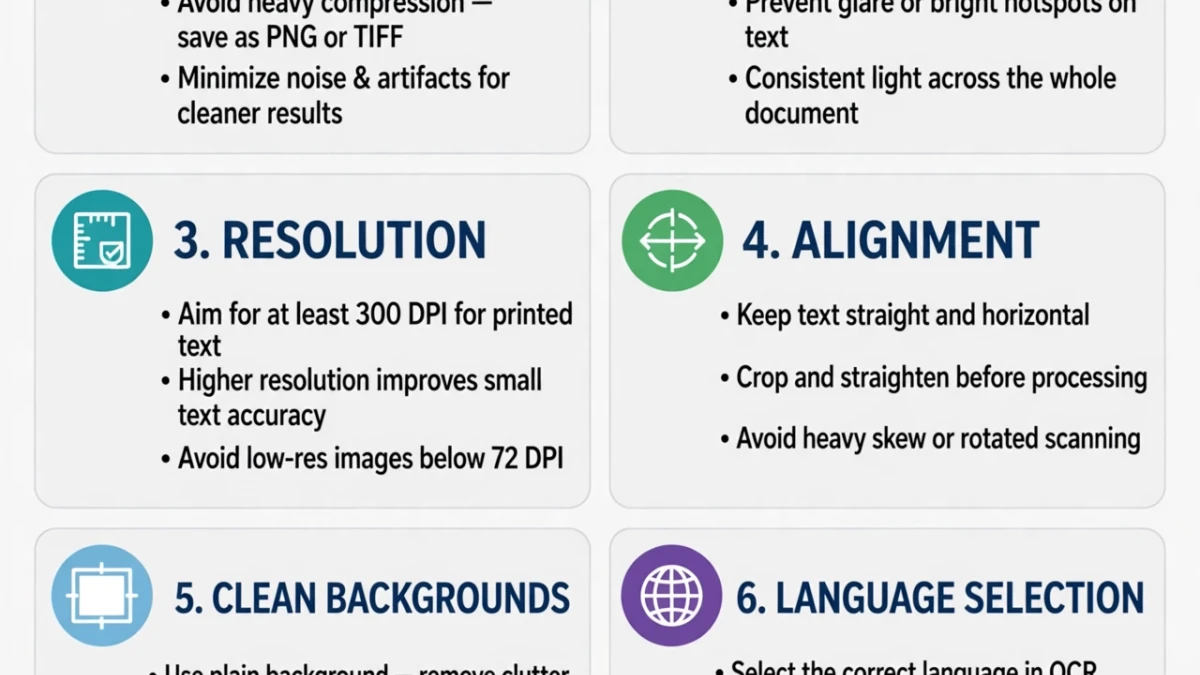
Yüksek doğruluk için en iyi uygulamalar:
- Minimum 300 DPI'de tarayın
- Bir belgenin fotoğrafını çekerken iyi ışıklandırma sağlayın (gölgelerden ve parlamadan kaçının)
- Sayfaları ortadan kaldırmak için kitapları ve belgeleri düzleştirin eğrilik
- Belge için doğru dili seçin
Önerilen Yardımcı Kılavuzlar
Dijital iş akışınızı geliştirmek için bu konu kümesindeki tamamlayıcı eğitimleri ve yardımcı programları keşfedin: