
OCR 技术的工作原理

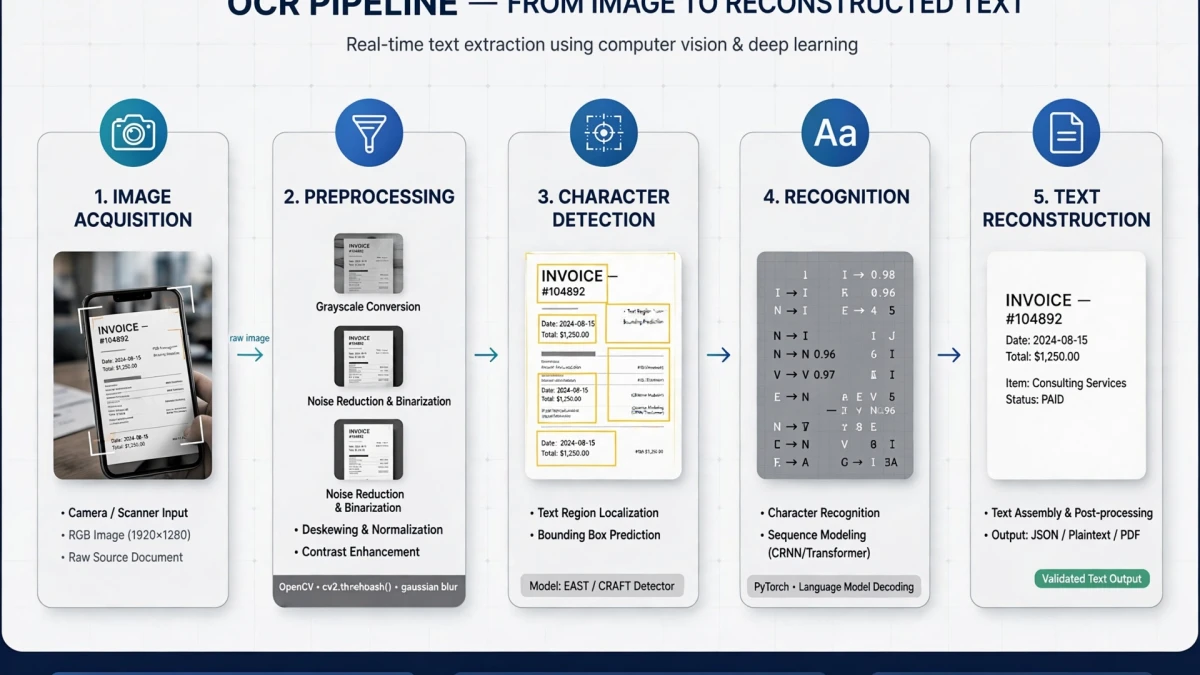
光学字符识别使用计算机视觉来识别图像中的文本字符。现代 OCR 管道:
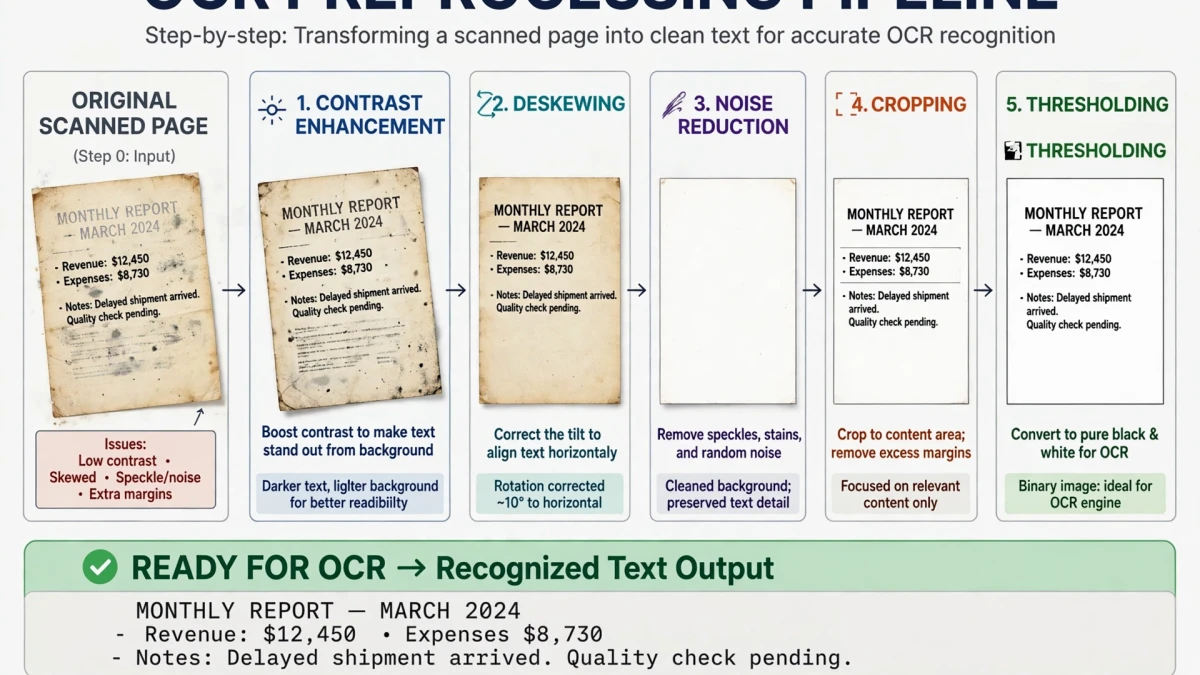
1。图像预处理在字符识别之前,对图像进行清理:
- Grayscale conversion (removes color noise)
- Binarization (converts to black and white)
- Deskewing (straightens tilted documents)
- Noise reduction (removes scanner artifacts and speckles)
- Line detection (identifies text rows)
2。 Character segmentation The preprocessed image is divided into individual character regions. For Latin scripts, this involves identifying word boundaries, then individual character boxes.
3。 Feature extraction Each character's features are extracted: stroke width, curves, intersections, aspect ratio, pixel density patterns.
4。模式匹配 将提取的特征与经过训练的字符模型进行比较。传统OCR采用模板匹配;现代 OCR 使用深度学习(卷积神经网络)将字符识别为整体模式,稳健地处理字体变化和退化。
5。上下文后处理语言模型根据字典和语法规则检查识别的字符,将上下文中的“1earn”纠正为“learn”,将“rn”误读为“m”。
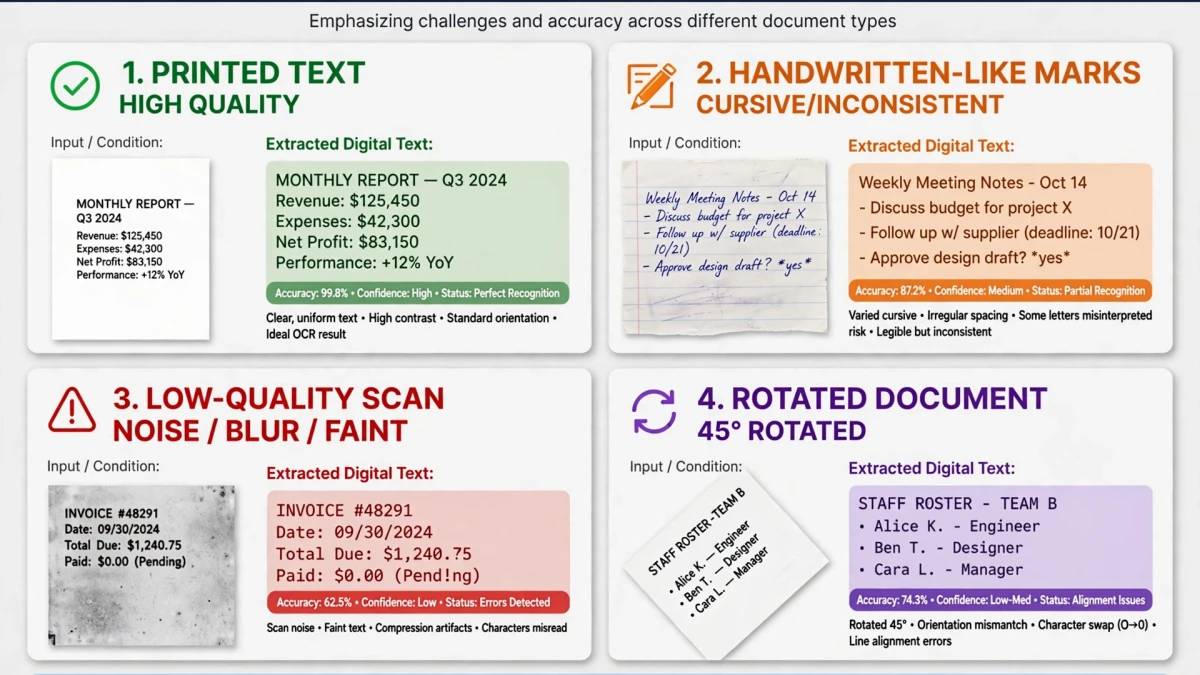
影响 OCR 准确性的因素
| 因素 | 影响准确度 |
|---|---|
| 扫描分辨率 (DPI) | 非常高 — 需要 300+ DPI 才能可靠结果 |
| 图像清晰度 | 非常高 - 模糊文本会导致错误 |
| 字体大小 | 高 - 8pt 以下的字体具有挑战性 |
| 字体类型 | 中等 - 衬线和无衬线效果很好;装饰字体很难 |
| 文档清洁度 | 高 — 会导致咖啡渍、折叠、铅笔痕迹错误 |
| 语言选择 | 高 - 选择错误的语言模型会降低准确性 |
| 文本颜色对比度 | 中等 - 白底黑字最佳 |
在 ToolDolfen 上使用 OCR
- 打开 图片转文字工具 (OCR) 工具。
- 上传扫描文档或文本照片。
- 选择文本语言(默认为英语;其他语言可用)。
- 点击提取文本。
- 查看输出并更正所有识别错误。
- 将提取的文本复制到您的剪贴板。
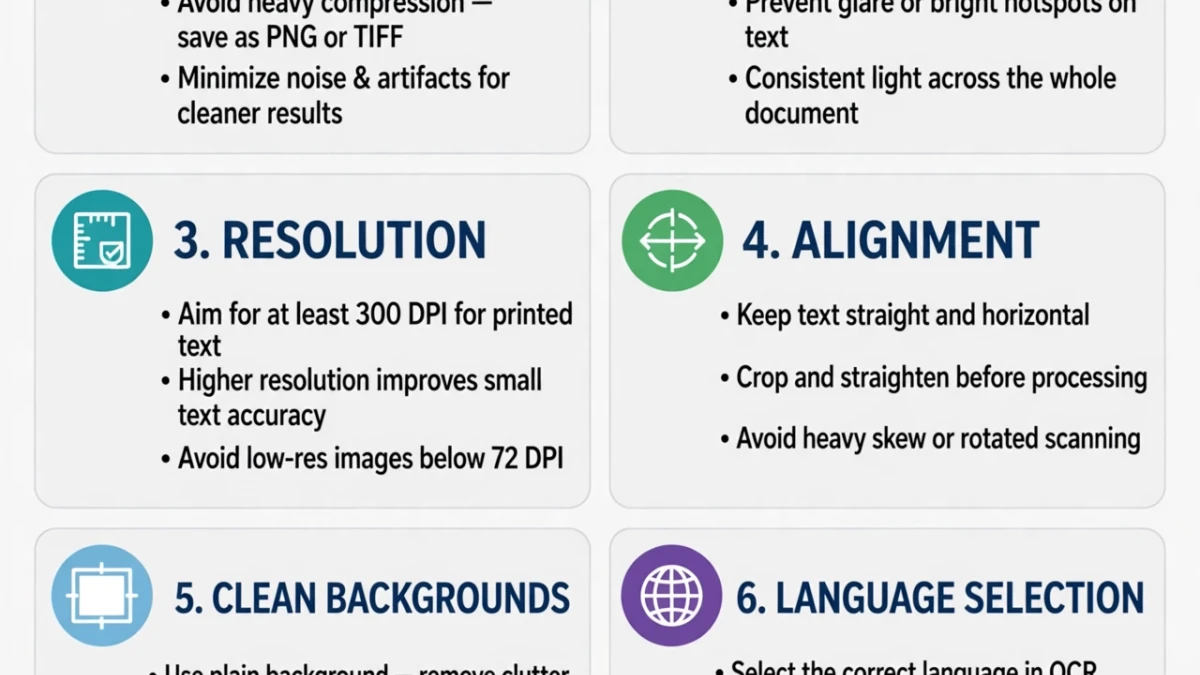
高精度最佳实践:
- 以最低 300 DPI 的分辨率扫描
- 拍摄文档时确保光线充足(避免阴影和眩光)
- 压平书籍和文档以消除页面弯曲
- 为文档选择正确的语言文档